カテゴリー: 技術系

  • 「読み終えた」をどう数えるか

    「読み終えた」をどう数えるか

    「この記事は最後まで読まれたのか」を数えたい。

    GA4には最初からスクロール距離の計測がありますが、今回はそれを使いませんでした。使わなかった理由と、代わりに何を測ることにしたか。そして確認の途中で、自分の測り方のほうが間違っていたという話です。

    この記事で扱うこと

    スクロール率で読了を測ることの問題、サイト側にすでにある読了状態を使うという判断、「未読から読了に変わった瞬間」だけを送る実装。最後に、計測は必ず一部を取りこぼすという前提について。

    スクロール率では「読んだ」と言えない

    GA4の拡張計測には scroll というイベントがあり、1回の表示の中で画面が90%まで下がると発火します。設定を1つ入れるだけで使えます。

    それでも使わなかったのは、測っているものが違うからです。

    場面 scrollは発火するか 実際に読んだか
    最後まで読み進めた する 読んだ
    目次から最後の見出しへ飛んだ する 読んでいない
    末尾までスクロールだけした する 読んでいない
    同じ記事を3回開いた 3回する 読了は1回

    下3行が問題です。スクロール率が測っているのは「画面が下まで移動したか」であって、「その人が読み終えたか」ではありません。近い場面が多いので代用できているように見えますが、別のものです。

    特に最後の行は効きます。気に入った記事ほど開き直されるので、読まれている記事ほど水増しされるという、いちばん困る方向に歪みます。

    すでに答えを持っていた

    このサイトには、以前から読了状態を保存する仕組みがあります。記事を最後まで読むと、そのことをブラウザ(localStorage)に記録し、一覧に「読了済み」のバッジを出す機能です。

    つまり「この人がこの記事を読み終えたか」は、すでにサイトが知っていました。計測のために新しく測り直す必要はなく、その状態が変わった瞬間を送ればいい。

    測り直さない

    同じことを2か所で測ると、必ずどこかでずれます。ずれたとき、どちらが正しいかを毎回考えることになります。すでに持っている情報を使うほうが、増やす手間も、あとで悩む回数も少なくて済みます。

    「変わった瞬間」を返させる

    読了を記録する関数は、もともと何も返していませんでした。

    変更前
    export function markAsRead(slug: string): void {
      const current = getReadSlugs();
      if (current.includes(slug)) return;   // すでに読了なら何もしない
      // 保存する
    }

    ここで注目したいのは、この関数はすでに「読了済みかどうか」を知っているということです。3行目で判定しています。知っているのに、その情報を捨てていました。

    そこで、戻り値を持たせました。

    変更後
    export function markAsRead(slug: string): boolean {
      try {
        const current = getReadSlugs();
        if (current.includes(slug)) return false;   // 再訪
    
        window.localStorage.setItem(KEY, JSON.stringify([...current, slug]));
        return true;                                // 新しく読了になった
      } catch {
        // 保存できない環境(プライベートモード等)では判定材料が無い。
        // 呼び出し側がページ内で1回に制限しているので、そこで歯止めがかかる。
        return true;
      }
    }

    呼び出し側は、これが true のときだけ計測へ送ります。

    MarkAsRead.tsx(要点)
    const isNewlyRead = markAsRead(slug);
    if (!isNewlyRead) return;
    
    window.dataLayer.push({
      event: "article_read",
      article_slug: slug,
      article_title: title,
    });

    結果として、1つの記事から送られる読了は、そのブラウザにつき1回だけになります。再訪しても増えません。読了数が再訪回数に化けることがなくなりました。

    呼び出し側で判定しなかった理由

    「読了済みかどうか」を呼び出し側でもう一度調べることもできました。しかしそうすると、同じ判定が2か所に存在します。片方の条件を変えたときに、もう片方を直し忘れます。すでに判定している場所に、判定結果を返させるほうが素直でした。

    タグマネージャー側の設定

    サイトから送られた article_read を、GTMで受け取ってGA4へ流します。作ったのは変数2つ、トリガー1つ、タグ1つです。

    GTMの構成
    変数     DLV - article_slug     データレイヤー変数 article_slug
    変数     DLV - article_title    データレイヤー変数 article_title
    トリガー CE - article_read      カスタムイベント article_read
    タグ     GA4 - article_read     GA4イベント / イベント名 article_read
                                    パラメータに上の2変数を付与

    スラッグとタイトルを両方送っているのは、レポートでどの記事が読み切られたかを記事単位で見るためです。スラッグだけだと一覧が英数字の羅列になり、読めません。

    GTMでバージョンを公開した画面
    公開時には必ず説明を書く。半年後の自分が、どのバージョンに戻せばいいか判断できなくなるため。

    動かないときは、測り方を疑う

    実装が終わり、本番で確認しました。記事を最後までスクロールさせても、読了に切り替わりません。進捗表示は「あと100%」のままでした。

    コードを疑って何度か読み返しましたが、間違いは見つかりませんでした。そこで、確認に使っていたスクリプトのほうを調べました。

    やっていたこと
    document.documentElement.scrollTop = 一番下;

    スクロール位置は確かに変わっていました。しかし進捗を計算している処理は、スクロールイベントを受け取って動きます。この方法では、そのイベントが期待どおりに発生していませんでした。

    イベントを明示的に発生させたところ、即座に読了になり、計測も送られました。

    対象より先に、測り方を疑う

    「動かない」と思ったとき、疑う先はまず対象のコードになります。しかし今回、間違っていたのは確認する側でした。手で操作していれば一度で分かったはずのことに、時間を使いました。以前にも正規表現の数え方を間違えて、コードのせいだと思い込んだことがあります。同じ形の失敗です。

    数字が1件も届かない

    読了イベントがブラウザ内で発火することは確認できました。ところが、GA4の管理画面には「受信したデータはまだありません」と出たままでした。

    サイトからGTMへの受け渡しは、この目で確認しています。止まっているとすれば、その先です。ネットワークの記録を見ました。

    読み込まれていたもの
    chrome-extension://(拡張機能のID)/
        rule_resources/redirects/google-analytics_analytics.js

    広告ブロッカーが、Googleの計測スクリプトを無害化した別のファイルに差し替えていました。gtm.js の取得自体は成功(200)しているのに、コンテナは動いていない。読み込まれてはいるが、実行されていない状態です。

    別の端末で同じ記事を読んだところ、そちらは正しく届きました。

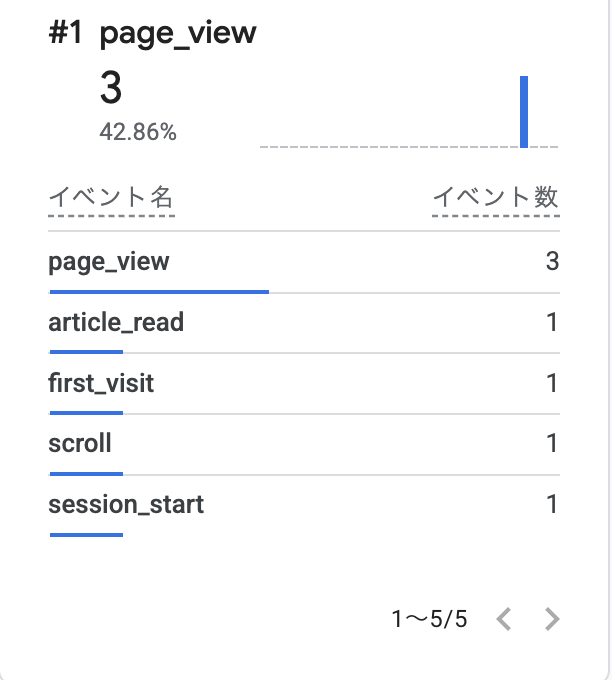
    GA4のリアルタイムでarticle_readが1件記録されている画面
    ページビューに混ざって article_read が1件。読了が数えられている。

    計測は必ず一部を取りこぼす

    この経験には、設定の話より大きな中身がありました。

    閲覧者の一定割合は広告ブロッカーを使っています。つまりアクセス解析の数字は、はじめから実数より少なく出ます。これは不具合ではなく、仕様として受け入れるしかない前提です。

    知らないと、2つの困ったことが起きます。ひとつは、正常なのに「壊れている」と考えて原因を探し続けること。実際、私はしばらくそう考えていました。もうひとつは、数字を実数だと思って判断してしまうことです。

    絶対値ではなく、傾向として読む

    取りこぼしがあっても、記事どうしの比較は成立します。どの記事がよく読まれたか、読了率が高いのはどれか。取りこぼす割合はどの記事でも似た程度なので、比べる分には使えます。「何人が読んだか」ではなく「どちらがよく読まれたか」を見る道具だと考えるのが実態に合っています。

    今回の学び

    まず、近い場面で発火するものは、同じものではないということ。スクロール率は読了と多くの場面で一致しますが、目次から飛んだときも、読まずに流したときも発火します。名前が似ているだけで代用すると、あとで数字の意味を説明できなくなります。

    次に、すでに知っている情報を捨てないこと。読了を記録する関数は、すでに「読了済みかどうか」を判定していました。その結果を返させるだけで、呼び出し側の二重判定がなくなりました。新しく調べるより、判定している場所に返させるほうが素直です。

    そして、動かないときは対象より先に測り方を疑うこと。今回いちばん時間を無駄にしたのがここでした。数が合わないときは、だいたい数え方のほうが間違っています。

    最後に、計測は完全ではないと知ったうえで使うこと。0件を見て慌てるか、「そういうものだ」と分かって傾向を読むか。前提を持っているかどうかで、同じ数字から引き出せるものが変わります。

  • 「来なかった人」を見るために

    「来なかった人」を見るために

    アクセス解析は「来た人」しか教えてくれません。

    検索結果に出たのに押されなかった、そもそも検索結果に出ていない——こうした「来なかった人」の情報は、GA4には一切残りません。それを見るための道具がGoogle Search Consoleです。今回はその導入と、所有権の確認方法を選ぶまでの判断を記録します。

    この記事で扱うこと

    Search ConsoleとGA4の役割の違い、ドメインプロパティとURLプレフィックスの選び分け、5つある所有権確認方法のうちどれを選んだか。そして、確認コードをコードに直接書かなかった理由。

    GA4では見えないもの

    まず、2つの道具が何を見ているのかを整理します。境界を勘違いすると、片方に無いものを延々と探すことになります。

    Googleアナリティクス Search Console
    見る対象 サイトに来た後の行動 サイトに来る前の状況
    データの出どころ サイトに埋めたタグ Googleの検索システム
    分かること 閲覧ページ、滞在、遷移、流入元 検索語、表示回数、順位、クリック率
    分からないこと どんな言葉で探されたか サイト内で何をしたか

    この違いがはっきり出るのが検索語です。GA4は「Google検索から来た」ことは分かりますが、何と入力して来たのかは教えてくれません。プライバシー保護のため、検索エンジン側が渡していないからです。

    Search Consoleは検索エンジン側の記録なので、そこが見えます。さらにクリックされなかった表示も数えられています。これがGA4には原理的に存在しない情報です。

    表示されているのに押されていない、が分かる

    ある記事が検索結果に100回出て、クリックが2回だとします。GA4に残るのは「2」だけです。Search Consoleを見ると「100回出ている」と分かるので、内容ではなくタイトルの問題だと切り分けられます。逆に表示が0なら、書き方以前に見つけられていません。直す場所がまったく変わります。

    プロパティの種類を選ぶ

    登録の最初に、2種類のどちらかを選ばされます。

    ドメイン URL プレフィックス
    対象 すべてのサブドメイン、http/https両方 入力したアドレスの配下だけ
    確認方法 DNSの設定のみ 5種類から選べる
    向いている場面 サブドメインをまとめて見たい 特定の1サイトだけ見たい

    今回はURLプレフィックスを選び、https://www.kisaku.site/ を登録しました。

    理由は2つあります。ひとつは、このサイトには cms.kisaku.site/wp/ というWordPress用のサブドメインがあり、そこは検索結果に出したくないからです。ドメインプロパティにすると、見せたくない側の数字まで一緒に入ってきます。

    もうひとつは、確認方法の選択肢です。ドメインプロパティはDNSレコードの追加が必須で、ドメイン管理会社の画面での作業になります。設定を間違えるとサイト全体が見えなくなる場所なので、必要のない作業は入れたくありませんでした。

    wwwの有無は別物として扱われる

    URLプレフィックスでは、https://kisaku.site/ と https://www.kisaku.site/ は別のプロパティです。転送を設定していても自動では統合されません。登録するのは転送先——つまり実際に表示されるほうです。ここを間違えると、いつまでもデータが0のままになります。

    所有権の確認方法

    URLを入力すると、そのサイトが自分のものだと証明するよう求められます。方法は5つ提示されました。

    方法 やること 今回の判断
    HTMLファイル 指定のファイルをサイト直下に置く ×
    HTMLタグ metaタグを head に入れる 採用
    Googleアナリティクス GA4のタグが入っていれば通る ×
    Googleタグマネージャー GTMのタグが入っていれば通る ×
    DNSレコード ドメイン設定にTXTを追加 ×

    HTMLファイル方式を外したのは、Next.jsで public に置くこと自体はできるものの、この1ファイルが何のためにあるのか、後から見て分からなくなるからです。ファイル名は意味を持たない英数字の羅列で、消しても当面は気づきません。そして消すと所有権が外れます。

    GA4やGTMを使う方式も外しました。一見いちばん楽ですが、計測を止めた瞬間に所有権の確認も外れます。将来「GTMをやめて直接タグを貼ろう」と判断したとき、Search Consoleまで巻き込まれます。関係のないもの同士を依存させない、という判断です。

    DNSは前述のとおり、影響範囲が大きすぎるので今回は使いませんでした。

    残ったHTMLタグ方式を選んでいます。head に1行入るだけで、これはNext.jsが正式に対応している範囲です。

    確認コードを直接書かなかった理由

    提示されるのはこういう1行です。

    Search Consoleが提示するタグ
    <meta name="google-site-verification" content="(英数字の文字列)" />

    これを layout.tsx にそのまま書いても動きます。しかし、環境変数から読む形にしました。

    layout.tsx(要点)
    export const metadata: Metadata = {
      metadataBase: new URL("https://www.kisaku.site"),
      // ...
      verification: {
        google: process.env.NEXT_PUBLIC_GOOGLE_SITE_VERIFICATION,
      },
    };

    Next.jsには verification という専用の項目が用意されていて、値を渡すと head にmetaタグを出力してくれます。手書きでタグを差し込む必要はありません。

    環境変数にした理由は、値が未設定なら何も出力されないからです。コードを先にデプロイしておいて、確認コードを取得してから設定を足せます。実際、今回はコードのほうが先にできていました。

    もうひとつ、この値がサイトの機能に関係ないものだという点も理由です。動作には一切影響しないので、コードの中に混ざっていると「何のための文字列か」を毎回思い出すことになります。設定として外に置けば、設定であることが見た目で分かります。

    この値は秘密ではない

    NEXT_PUBLIC_ が付いた環境変数は、ビルド時にコードへ埋め込まれ、誰でも見られる状態になります。この確認コードはもともとHTMLに出力するためのものなので、それで問題ありません。逆に言えば、秘密にすべき値をこの接頭辞で扱ってはいけません。接頭辞が「公開してよい」という宣言になっています。

    登録しただけでは確認されない

    metaタグがまだ本番に出ていないので、この時点でのプロパティは未確認の状態です。

    手順としてはこうなります。

    確認が通るまでの順番
    1. Search Consoleでプロパティを追加し、確認コードを控える
    2. Vercelの環境変数に確認コードを登録する
    3. 再デプロイする(環境変数の追加だけでは反映されない)
    4. Search Consoleに戻って「確認」を押す
    環境変数は追加しただけでは効かない

    NEXT_PUBLIC_ の値はビルド時にコードへ埋め込まれます。管理画面で追加しても、その後にビルドし直さなければ、出力されるHTMLは前のままです。「設定したのに反映されない」の大半はこれです。

    確認が通ったあとは、サイトマップの送信が次の作業になります。sitemap.xml をまだ用意していないので、これは別のタスクとして残しました。

    今回の学び

    まず、2つの道具は「来た後」と「来る前」で分かれているということ。GA4だけを見ていると、記事が読まれない理由を内容の問題だと考えがちです。実際には検索結果に出ていないだけかもしれません。直す場所を間違えないために、両方が要ります。

    次に、楽な確認方法ほど、他のものに依存していること。GA4やGTMを使う方式は一瞬で終わりますが、計測をやめた瞬間に所有権も外れます。関係のないもの同士を結びつけない——遠回りに見えても、独立させておくほうが後で自由が利きます。

    そして、設定はコードの外に置くと、設定に見えること。確認コードを直接書いても動きますが、コードの中に混ざると意味を思い出す手間が毎回かかります。環境変数にしておけば、それが「あとで変わりうる値」だと見た目で分かります。

  • ページを10枚見ても「1」と数えられる問題

    ページを10枚見ても「1」と数えられる問題

    ページを10枚見た人も、1枚見て帰った人も、同じ「1ページビュー」として記録される。

    Next.jsのようにページを読み込み直さないサイトに計測を入れると、初期状態ではこうなります。数字は出ているのに、実態とまったく合っていません。今回はGoogleタグマネージャー(GTM)を挟んで、この問題を解いた記録です。

    この記事で扱うこと

    GTMを経由させる理由、コンテナとタグとトリガーの関係、そしてページ内遷移を計測に伝える仕組み。最後に、二重計上を防ぐための設定をひとつ入れています。ここが今回いちばん判断を要した部分でした。

    なぜ計測タグを直接貼らないのか

    GA4は、測定IDを含む数行をサイトに貼れば動きます。GTMを挟むと手順が増えます。それでも挟む理由は、ひとつだけです。

    計測の内容は必ず後から変わるからです。

    今はページビューだけで十分でも、そのうち「どのリンクが押されたか」「記事をどこまで読んだか」「連絡先を見た人は何人か」を知りたくなります。タグを直接書いていると、そのたびにコードを直し、ビルドし、デプロイすることになります。

    タグを直接貼る GTMを挟む
    最初の設置 数行貼るだけ コンテナ作成+タグ設定
    計測を1つ足す コード修正 → ビルド → デプロイ GTMの画面だけ
    設定を戻す コードを戻して再デプロイ 前のバージョンを公開し直す
    変更でサイトが壊れる可能性 ある ない

    最後の行が本質です。計測を変えるたびにデプロイするということは、計測の都合でサイトが壊れる機会を作っているということでもあります。本来関係のない2つのことが、同じ操作に結びついています。

    GTMを入れると、この2つが切り離せます。コードを触らずに計測を変えられる——これがGTMを挟む唯一にして最大の理由です。

    コンテナは既存アカウントの下に作った

    GTMもGA4と同じく入れ子構造で、アカウントの下にコンテナがあります。

    GTMの階層
    アカウント(ポートフォリオ)
      └ コンテナ(www.kisaku.site)   ← サイト1つに対して1つ
          ├ タグ      : 何を送るか
          ├ トリガー  : いつ送るか
          └ 変数      : 何の値を送るか

    今回は新しいアカウントを作らず、すでにあった「ポートフォリオ」アカウントの下にコンテナを追加しました。個人で管理するサイトが増えたとき、アカウントを分けるとどこに何があるか分からなくなるからです。同じ管理単位に並べておけば、一覧で見つかります。

    アカウントを分けるべきなのは、アクセス権を分けたいときだけです。アカウント単位でユーザーを招待するので、他人に片方だけ渡したい場合は分ける必要があります。逆にそういう予定がないなら、分ける理由はありません。

    作成すると GTM- から始まるコンテナIDが発行されます。これがサイト側に埋め込む値です。測定IDと同じで、HTMLに出力されるので秘密ではありません。

    タグとトリガーという考え方

    GTMの設定は、この2つの組み合わせで表されます。

    用語 意味 今回の例
    タグ 何を送るか GA4にページビューを送る
    トリガー いつ送るか ページ内で移動したとき

    「いつ」と「何を」を分けて持つのがGTMの設計です。同じタグを複数のトリガーで使い回せますし、同じトリガーで複数のタグを一斉に発火させることもできます。

    今回作ったのは、タグ2つとトリガー1つです。

    作成した構成
    タグ1 : GA4 - Google タグ
            種類     Google タグ
            タグID   G-872K3PN503
            トリガー Initialization - All Pages
            設定     send_page_view = false
    
    タグ2 : GA4 - page_view (SPA)
            種類       GA4 イベント
            イベント名 page_view
            トリガー   CE - spa_page_view
    
    トリガー : CE - spa_page_view
            種類       カスタム イベント
            イベント名 spa_page_view

    タグ1がGA4本体の読み込み、タグ2がページビューの送信です。役割が分かれているところが今回の要点になります。

    ページ内の移動を計測に伝える

    ここからが本題です。

    Next.jsはリンクを押してもページ全体を再読み込みしません。画面の中身だけを差し替えて、アドレスバーを書き換えます。ブラウザから見れば「同じページのまま」なので、計測タグは何も気づきません。

    そこで、アドレスが変わったことを自分で検知して知らせる部品をサイト側に置きました。

    RouteChangeTracker.tsx(要点)
    const pathname = usePathname();
    const searchParams = useSearchParams();
    
    useEffect(() => {
      if (!window.dataLayer) return;
    
      const query = searchParams.toString();
      const pagePath = query ? pathname + "?" + query : pathname;
    
      window.dataLayer.push({
        event: "spa_page_view",
        page_path: pagePath,
        page_title: document.title,
      });
    }, [pathname, searchParams]);
    
    return null;

    dataLayer はGTMが監視している配列です。ここに event を含むオブジェクトを積むと、GTM側で「カスタムイベント」として拾えます。サイトとGTMの間の唯一の連絡口だと思えば分かりやすいです。

    この部品は画面に何も表示しません。return null しています。副作用だけを持つコンポーネントです。

    Suspenseで包む必要がある

    useSearchParams を使う部品は、Reactの Suspense で囲まないとビルド時に警告が出ます。囲まないと、そのページ全体が「事前生成できない」扱いになり、訪問のたびにサーバーで組み立てられるようになります。速度改善のために事前生成を入れたばかりだったので、ここは見落とせませんでした。計測を足したせいでサイトが遅くなる、というのは本末転倒です。

    GTM側では、このイベント名を待ち受けるトリガーを作ります。トリガーの種類は「カスタム イベント」、イベント名に spa_page_view と入れるだけです。あとはそのトリガーで、イベント名 page_view のGA4イベントタグを発火させます。

    二重計上を止める

    ここで問題が起きます。

    Googleタグは、読み込まれた時点で自動的にページビューを1回送ります。一方、上の RouteChangeTracker は useEffect で動くので、最初に表示されたときにも一度発火します。

    場面 Googleタグの自動送信 spa_page_view 記録されるPV
    最初にページを開く 1 1 2
    リンクで次のページへ 0 1 1

    最初の1ページだけが二重に数えられます。すべてのページが2倍になるならまだ気づけますが、入口のページだけが多く見えるという歪み方をします。これは気づきにくく、しかも「トップページが人気」という誤った結論を導きます。

    解決方法は2つ考えられました。

    案 やること 問題
    初回だけ送らない フロント側で「初回マウントかどうか」を判定して除外する 判定の条件がコードの中に隠れる。読み込み直しとの区別も難しい
    自動送信を止める Googleタグの send_page_view を false にする 設定を1つ追加するだけ

    後者を選びました。Googleタグの「設定」→「構成パラメータ」に、以下を追加しています。

    Googleタグの構成パラメータ
    send_page_view : false

    これでGoogleタグはGA4を読み込むだけになり、ページビューを送るのは spa_page_view 経由の1本だけになります。

    発生源をひとつにする

    同じ数字が2か所から出てくる状態は、どちらが正しいかを常に考え続けることになります。片方を止めて発生源を1本にするほうが、計測を足すたびに悩まずに済みます。設定の数を減らすことより、考える回数を減らすことのほうが効きます。

    IDが無いときは何も出力しない

    サイト側の読み込み部分には、もうひとつ仕掛けを入れています。

    Analytics.tsx(要点)
    const GTM_ID = process.env.NEXT_PUBLIC_GTM_ID;
    
    export default function Analytics() {
      if (!GTM_ID) return null;
      // ... GTMの読み込み
    }

    環境変数が設定されていなければ、何も出力しません。これで2つのことが同時に解決します。

    ひとつは、IDを取得する前にデプロイしても壊れないこと。コードを先に入れておいて、あとから設定を足せます。もうひとつは、手元の開発中の操作が本番の数値に混ざらないことです。自分でページを何度も開き直す作業をしている最中に計測が動いていると、その分がそのまま記録されます。

    公開を忘れると何も起きない

    GTMには最後にひとつ落とし穴があります。

    タグを作って保存しただけでは、サイトには反映されません。右上の「公開」を押してはじめて配信されます。

    作業中の状態を「ワークスペース」と呼び、公開すると「バージョン」として固定されます。バージョンには名前と説明を付けられるので、今回は次のように残しました。

    公開したバージョン
    名前 : v1 GA4初期設定
    説明 : Googleタグ(G-872K3PN503、send_page_view=false)
           +SPA用GA4イベントpage_view(カスタムイベントspa_page_view)

    ここを空欄で公開してしまうと、半年後に見たときに何をしたバージョンなのか分かりません。過去のバージョンに戻せるのがGTMの利点ですが、戻す先が分からなければ意味がありません。説明を書くのは、その利点を使えるようにしておく作業です。

    今回の学び

    まず、速いサイトほど計測が壊れるということ。ページを読み込み直さない仕組みは体験としては良いのですが、計測の前提を静かに崩します。表示が速いことと、計測が正しいことは、別々に確かめる必要がありました。

    次に、数字は「出ている」と「合っている」が違うこと。タグを貼ればリアルタイムに自分のアクセスが出るので、動いているように見えます。しかし中身は初回だけ2倍で、遷移は数えていない状態でした。動作確認の基準を「表示されるか」ではなく「意図した回数か」に置く必要があります。

    そして、同じことを2か所で管理しないこと。二重計上の対処で、フロント側を賢くする案とGTM側で止める案がありました。前者は判定条件がコードの中に隠れます。設定として見える場所に置いたほうが、あとから読み解けると判断しました。

  • GA4を入れる前に決めたこと

    GA4を入れる前に決めたこと

    サイトを作って公開しました。ここまで、誰がどのページを見ているのかを一度も見ていません。

    見なくても作れてしまうのが、個人サイトの怖いところです。手応えの代わりになるものが何もないまま、次に何を直すかを勘で決めることになります。今回はその状態を終わらせるために、Googleアナリティクス4(GA4)を入れました。

    この記事で扱うこと

    GA4のプロパティとデータストリームの作り方、そのときに聞かれる設問への答え方、測定IDの意味。そして「計測を入れる前に決めておくべきこと」。手順そのものより、なぜその選択をしたかを中心に書きます。

    計測を入れる前に決めたこと

    最初に、数字を見て何をするつもりなのかを決めました。これを決めずに入れると、毎日ダッシュボードを眺めて満足するだけの習慣ができます。

    このサイトで知りたいことは3つでした。

    知りたいこと それが分かると何ができるか
    どの記事が読まれているか 次に書く記事の題材を、勘ではなく実績で決められる
    どこから来ているか 検索経由が少なければ、書き方ではなく見つけられ方に問題があると分かる
    途中で離脱していないか 記事の構成や長さを見直す根拠になる

    逆に、追わないと決めたものもあります。ユーザー数の絶対値です。個人のポートフォリオで、月間の訪問者数を増やすこと自体を目標にすると、内容と関係のない集客に手が伸びます。ここでは「読まれ方の質」だけを見ることにしました。

    アカウントとプロパティの関係

    GA4は入れ子構造になっていて、最初にここでつまずきます。

    GA4の階層
    アカウント(KiSAKU)
      └ プロパティ(kisaku.site)        ← データが貯まる単位。レポートはここで見る
          └ データストリーム(ウェブ)    ← 計測タグを置く対象。1つのURL群に対応する

    覚え方としては、プロパティが「1つのサービス」、データストリームが「その入り口」です。ウェブサイトとiOSアプリを両方持っているなら、プロパティは1つでストリームが2つになります。同じサービスの利用者を、端末ごとに分断せずに見られます。

    逆に、まったく別のサイトを同じプロパティに入れてはいけません。レポートが混ざって、どちらの数字も読めなくなります。今回は kisaku.site 専用のプロパティを新しく作りました。

    作成時に聞かれること

    プロパティを作ると、いくつか設問が出ます。あとから変更できるものと、しにくいものがあります。

    項目 設定した値 あとから変えられるか
    タイムゾーン 日本(GMT+09:00) 変えられるが、過去のデータは変換されない
    通貨 日本円 同上
    業種 コンピュータ、電化製品 いつでも変更可
    ビジネスの規模 小規模 いつでも変更可
    ビジネス目標 トラフィックの分析/エンゲージメントと維持率の把握 いつでも変更可
    タイムゾーンだけは最初に正しく

    初期値はアメリカの時間帯です。そのままにすると「日付の変わり目」がずれ、日別レポートが実感と合わなくなります。しかも後から直しても、すでに記録されたデータは古い時間帯のままです。最初の1回しか正しく設定する機会がありません。

    業種と規模は、初期レポートの構成を決めるためのものです。間違えても実害はほとんどありません。ビジネス目標も同様で、選んだ内容に応じて左メニューの項目が変わるだけです。ここで悩んで手が止まるくらいなら、近いものを選んで先に進むべきです。

    データストリームと測定ID

    プロパティを作ると、続けてデータストリームの作成を求められます。ここで入力するのは計測対象のURLです。

    設定した内容
    ストリーム名 : kisaku.site ウェブ
    ウェブサイトのURL : https://www.kisaku.site
    ストリームID : 15464874599
    測定ID : G-872K3PN503

    URLに www を付けたのは、このサイトの正規のアドレスが www.kisaku.site だからです。kisaku.site(wwwなし)にアクセスすると、www 付きへ転送されます。転送先のほうを登録するのが正しい選び方です。

    ここで出てくる G- から始まる文字列が測定IDです。これがサイトとGA4のプロパティを結びつける鍵になります。

    測定IDは秘密ではない

    この値はサイトのHTMLに出力され、ブラウザの開発者ツールで誰でも見られます。隠す必要はありませんし、隠せません。パスワードやAPIキーと同じ扱いをする必要はない、と最初に理解しておくと迷わずに済みます。

    タグを直接貼らなかった理由

    GA4は、測定IDを含む数行のスクリプトをサイトに貼れば動きます。それがいちばん短い道です。

    しかし今回は貼りませんでした。代わりにGoogleタグマネージャー(GTM)を経由させています。

    理由は、計測の内容は必ず後から変わるからです。今はページビューだけで十分でも、そのうち「どのリンクが押されたか」「記事をどこまで読んだか」を知りたくなります。タグを直接書いていると、そのたびにコードを直し、ビルドし、デプロイすることになります。

    デプロイが必要ということは、計測を変えるたびにサイトが壊れる可能性が生まれるということでもあります。本質的に関係のない2つのことが、同じ操作に結びついてしまっています。

    GTMを挟むと、この2つが切り離せます。計測の変更はGTMの画面だけで完結し、サイトのコードには一切触れません。GTMの構成は次の記事で扱います。

    なぜ「入れただけ」では不十分なのか

    ひとつだけ、先に書いておきます。

    このサイトはNext.jsで作られていて、リンクを押してもページ全体を読み込み直しません。画面の中身だけを差し替えて、アドレスバーの表示を書き換えます。表示は速くなりますが、計測の側から見ると「1回読み込まれたきり、ずっと同じページを見ている」ようにしか見えません。

    この状態で放置すると、記事を10本読んだ人も、トップページだけ見て帰った人も、同じ「1ページビュー」として記録されます。

    入れて安心するのがいちばん危ない

    タグを貼ってリアルタイムに自分のアクセスが出れば、動いているように見えます。しかしこの状態のGA4は、実態とかけ離れた数字を、正しい顔で出し続けます。数字が無いより、間違った数字があるほうが判断を誤ります。

    この対処が、今回いちばん手間のかかった部分です。次の記事で扱います。

    今回の学び

    まず、計測は「入れる」より「何を見るか決める」ほうが先だということ。ツールは何でも記録してくれますが、見る対象を決めていないと、記録されたものを眺めるだけで終わります。追わないものを決めておくのも同じくらい大事でした。

    次に、最初の1回しか設定できない項目があること。タイムゾーンがそれでした。あとで直せる項目とそうでない項目が同じ画面に並んでいて、見た目からは区別できません。「変えられるか」を先に調べるだけで、後戻りの多くは防げます。

    そして、短い道が最善とは限らないこと。タグを直接貼れば5分で終わりました。GTMを挟んだぶん手順は増えましたが、この先の変更が全部コードの外側で済むようになります。一度きりの作業を短くするか、繰り返す作業を短くするかという選択でした。

  • 速くしたら、壊れた — 表示1.7秒を0.03秒にするまでと、その代償

    速くしたら、壊れた — 表示1.7秒を0.03秒にするまでと、その代償

    サイトの表示が遅い、という話から始まった作業です。結果として最初の1バイトが返るまでの時間は約1.7秒から0.03秒になりました。50倍以上です。

    ただしこの記事の本題は、その数字ではありません。速くしたことで、別の場所が壊れたという話です。デプロイが失敗し、画像がぼやけ、一覧が読めなくなりました。どれも高速化そのものが引き起こしたものです。

    この記事で扱うこと

    計測から原因を特定する手順、Next.jsのキャッシュがどこに効いてどこに効かないか、事前生成とISR、そして「速くするための選択が壊れやすさを生む」という構造。最後に、自分の計測を自分で壊した失敗も書きます。

    まず測る

    「遅い気がする」から始まる改善は、たいてい見当違いの場所を触って終わります。数字が無いと、直したかどうかも判断できません。

    使ったのは curl だけです。

    最初の1バイトが返るまでの時間を測る
    curl -s -o /dev/null \
      -w "合計:%{time_total}s  最初の1バイト:%{time_starttransfer}s\n" \
      https://www.kisaku.site/

    見るべきは time_starttransfer、最初の1バイトが返るまでの時間です。体感の遅さはほぼここで決まります。この値が大きいと、画面が真っ白なまま待たされます。逆にここが小さければ、多少ファイルが大きくても「表示され始めた」感覚は得られます。

    フロントとCMSの両方を測りました。

    対象 最初の1バイトまで
    フロント(1回目) 3.25秒
    フロント(2回目) 1.85秒
    フロント(3回目) 1.72秒
    CMSのGraphQL 2.29秒

    3回繰り返しているのには理由があります。1回目は暗号化通信の確立が含まれるので必ず遅くなります。1回だけ測って「3.2秒だ」と判断すると、実力値を1.5秒以上見誤ります。

    この表から読み取れることは明確でした。フロントの実力値が約1.7秒、CMSが約2.3秒。つまりフロントの待ち時間は、ほぼそのままCMSの応答時間です。Vercel自体の処理はごくわずかで、大半は共用サーバーのWordPressがPHPとMySQLを動かし終わるのを待っている時間でした。

    犯人は自分が書いた3文字だった

    原因はGraphQLクライアントのこの指定でした。

    src/lib/graphql-client.ts(修正前)
    export const graphqlClient = new GraphQLClient(endpoint, {
      fetch: (input, init) =>
        fetch(input, {
          ...init,
          cache: "no-store",   // ← これ
        }),
    });

    cache: "no-store" は「結果を一切キャッシュしない」という指定です。Next.jsはこれを見つけると、そのページを事前に生成できないと判断します。訪問者が来るたびに、その場でCMSへ問い合わせて組み立てる方式になります。

    ビルド結果にも、はっきり出ていました。

    修正前のビルド結果
    Route (app)
    ┌ ƒ /
    ├ ƒ /blog
    ├ ƒ /blog/[slug]
    ├ ƒ /profile
    ├ ƒ /projects
    └ ƒ /skills
    
    ƒ  (Dynamic)  server-rendered on demand

    全ページに ƒ の印。すべてが「訪問時に組み立てる」状態でした。この情報は毎回のビルドで表示されていたのに、意味を確認していませんでした。

    この指定を入れたのは「記事を公開したらすぐ反映されるように」という意図でした。狙い自体は正しかったのですが、その代償として全ページが毎回CMS待ちになることを見落としていました。

    キャッシュは、思ったところに効かない

    直し方は単純に見えました。no-store を外して、代わりに「5分間キャッシュする」と書けばいい。

    ところが、ここで一段深い問題に当たりました。

    Next.jsのfetchキャッシュはGETにしか効かない

    Next.jsには fetch の結果を自動でキャッシュする仕組みがありますが、対象はGETリクエストだけです。GraphQLは通常POSTでクエリを送ります。つまり fetch に revalidate を指定しても、素通りして何も起きません。

    気づかずに進めていたら、「設定したのに速くならない」という状態で長く悩んだはずです。

    解決には unstable_cache を使いました。これは fetch に限らず、関数の戻り値そのものをキャッシュできる仕組みです。

    src/lib/data.ts
    import { unstable_cache } from "next/cache";
    
    export const getPosts = unstable_cache(
      async () => {
        const data = await graphqlClient.request(GET_POSTS);
        return data.posts?.nodes ?? [];
      },
      ["posts"],                                    // キャッシュキーの一部
      { revalidate: 300, tags: ["wordpress"] },     // 300秒保持
    );

    引数も自動的にキャッシュキーに含まれるので、getPostBySlug("a") と getPostBySlug("b") は別物として扱われます。

    名前に unstable_ と付いていますが、これは「将来APIが変わるかもしれない」という意味で、動作が不安定という意味ではありません。

    tags を付けているのは将来のためです。WordPressで記事を公開したときにVercelへ通知を送る仕組みを足せば、5分待たずに反映できます。今は使っていませんが、後から足せるように印だけ置いています。

    ページ自体も事前に作る

    あわせて、各ページに1行足しました。

    各 page.tsx の先頭
    export const revalidate = 300;

    これでNext.jsはページを事前に生成し、300秒ごとに裏側で作り直します。訪問者はCMSの応答を待ちません。

    ただし記事ページは、これだけでは足りませんでした。/blog/[slug] は「どんなスラッグが存在するか」をNext.jsが知らないため、事前に作りようがないからです。そこで一覧を教えます。

    src/app/blog/[slug]/page.tsx
    export async function generateStaticParams() {
      const posts = await getPosts();
    
      return posts
        .map((post) => post.slug)
        .filter((slug): slug is string => Boolean(slug))
        .map((slug) => ({ slug }));
    }

    結果

    ページ 改善前 改善後 状態
    トップ 約1,720ms 25〜35ms キャッシュ命中
    記事ページ 約1,720ms 26〜29ms キャッシュ命中
    実績 約1,720ms 23ms キャッシュ命中
    ブログ一覧 約1,720ms 242ms 毎回生成

    ブログ一覧だけが動的なままです。?category= で内容が変わるページは事前に作れません。それでも1.7秒から242msになりました。CMSへの問い合わせが消え、残っているのは画面を組み立てる時間だけだからです。

    自分の計測を、自分で壊した

    ここで恥ずかしい失敗をしました。

    デプロイ後に測り直したところ、全ページが1.4〜2.6秒。しかも配信網の状態を示すヘッダが、どれも MISS(キャッシュに無い)でした。一瞬「効いていないのか」と思いました。

    原因は私が測り方に入れたキャッシュ除けのパラメータでした。

    やってしまった測り方
    // 毎回ちがうURLになる
    await fetch('/blog?nc=' + Date.now());

    ブラウザのキャッシュを避けるつもりで付けたものですが、配信網から見れば毎回まったく新しいURLです。キャッシュに無いのは当たり前でした。パラメータを外して測り直したのが、上の表の数字です。

    教訓としては、測定の道具が測定対象に影響していないかを疑うということになります。結果がおかしいとき、まずシステムを疑いたくなりますが、測り方のほうが壊れていることは珍しくありません。

    速くした代償で、デプロイが止まった

    ここからが本題です。

    サムネイル画像を記事に紐づけ、一覧のクエリに画像の情報を足して本番に送ったところ、デプロイが失敗しました。

    Vercelのビルドログ
    GraphQL Error (Code: 500)
    <title>500 Internal Server Error</title>
    <p>Please contact the server administrator,
     webmaster@gmoserver.jp ...</p>
    
    > Build error occurred
    Error: Failed to collect page data for /blog/[slug]

    エラーの中身は、共用サーバーが返したApacheの標準エラーページでした。WordPressが処理しきれず、サーバー側で落ちていました。

    ここで重要なのは、なぜ今回から落ちるようになったのかです。

    以前は全ページが動的だったので、ビルド中にCMSへ問い合わせることはありませんでした。CMSが500を返しても、影響は「その1回の表示が失敗する」だけです。

    事前生成に切り替えたことで、ビルド時にCMSへ問い合わせる経路が生まれました。そこへ画像の情報を足したため処理が重くなり、共用サーバーが応答しきれなくなりました。

    構造として理解しておきたいこと

    速くするための最適化は、たいてい依存関係を増やします。事前生成は「ビルド時点でデータが取れる」ことを前提にしています。前提が増えれば、壊れる条件も増えます。速さと壊れにくさは、多くの場合トレードオフの関係にあります。

    2つの対策

    ひとつは、5xxエラーのときに自動で投げ直すことです。

    src/lib/graphql-client.ts
    const MAX_ATTEMPTS = 3;
    const RETRY_DELAY_MS = [1000, 3000];   // 1秒後、3秒後
    
    async function fetchWithRetry(input, init) {
      for (let attempt = 0; attempt < MAX_ATTEMPTS; attempt++) {
        if (attempt > 0) await wait(RETRY_DELAY_MS[attempt - 1]);
    
        const response = await fetch(input, init);
    
        // 5xx はサーバー側の一時的な不調の可能性が高いので投げ直す。
        // 4xx はこちらの要求が間違っているので、何度試しても同じ。
        if (response.status >= 500 && attempt < MAX_ATTEMPTS - 1) continue;
    
        return response;
      }
    }

    すぐ投げ直さず間隔を空けているのは、混んでいる相手にすぐ投げ直しても意味がないからです。むしろ負荷を増やします。また、再試行するのは5xxだけにしました。4xxを何度試しても結果は変わらず、ただの遅延になります。

    もうひとつは、事前生成の失敗でビルドを止めないことです。

    src/app/blog/[slug]/page.tsx
    export async function generateStaticParams() {
      try {
        const posts = await getPosts();
        return posts.map(/* ... */);
      } catch (error) {
        console.warn("記事一覧を取得できなかったため、事前生成をスキップします", error);
        return [];   // 空を返す = 訪問時に生成する方式へ切り替わる
      }
    }

    判断の根拠は、この処理の役割が「どのページを先に作っておくか」を決めることでしかないという点です。失敗しても致命的ではありません。最初の1人が待つ代わりに、デプロイは通ります。

    なお、デプロイが失敗しても本番サイトは無事でした。Vercelは失敗時に切り替えを行わず、前回成功した内容を配信し続けます。失敗したデプロイは「何も起きない」で済むという設計です。

    画像を足したら、今度は画像が壊れた

    デプロイが通り、サムネイルが表示されるようになりました。しかし画面を見ると、2つ問題がありました。

    1. 画像が大きすぎた

    ブログ一覧は1列なので、カード幅いっぱいに1200×630の画像を置くと高さが454pxになり、1件で画面の半分近くを占めていました。

    一覧の役割は「複数の記事を見比べて選ぶ」ことです。1件ずつしか見えない一覧は、一覧として機能していません。画像を左、文字を右の横並びに変え、画像の幅を256pxに収めました。

    2. 画像がぼやけていた

    調べると、配信されていた画像は450px幅なのに、864pxに引き伸ばして表示されていました。原因は自分が書いた指定です。

    間違っていた指定
    <Image
      src={...}
      fill
      sizes="(min-width: 768px) 720px, 100vw"   // 実際は864pxだった
    />

    sizes は「この画像は画面上でどれくらいの幅で表示されるか」をブラウザに伝えるものです。ブラウザはこの申告を信じて、取ってくる画像の大きさを決めます。申告が小さすぎれば拡大されてぼやけ、大きすぎれば無駄に重い画像を取ります。

    横並びに変更して表示幅が256pxで確定したので、申告もそれに合わせました。実寸と申告が一致していることが重要です。

    今回の学び

    まず、測ってから直す。今回は最初に測ったおかげで、原因が「Vercelの処理」ではなく「CMSの応答待ち」だと即座に分かりました。測らずに始めていたら、画像の圧縮やJavaScriptの削減といった、効果のない場所を触っていたはずです。

    次に、キャッシュは「効いているつもり」が最も危ない。POSTには fetch キャッシュが効かない、という一点を知らなければ、設定したのに変わらない状態で長く悩んでいました。仕組みがどこに効いてどこに効かないかは、思い込みではなく確認する必要があります。

    そして、最適化は依存関係を増やす。事前生成は「ビルド時にデータが取れる」という前提の上に成り立っています。前提が増えれば壊れる条件も増えます。速くするときは、同時に「壊れたときにどうなるか」を決めておくべきでした。今回は壊れてから決めることになりました。

    最後に、ブラウザに嘘をつかない。sizes の件は、こちらの申告をブラウザが信じて動く仕組みでした。人間が見て分かる間違いではなく、画面がぼやけるという形でしか現れません。自動で最適化してくれる仕組みほど、渡す情報の正しさが結果を決めます。

  • 自分のブログに記事が投稿できない — WAFの誤検知と、渡し方を変える解決

    自分のブログに記事が投稿できない — WAFの誤検知と、渡し方を変える解決

    自分のブログに、自分で書いた記事が投稿できなくなりました。

    原因はサーバーのWAF(Webアプリケーションファイアウォール)でした。記事の本文に含まれるコードが、攻撃と誤検知されて遮断されていたのです。回避を4種類試して全部失敗し、最後に「内容を変えずに、渡し方を変える」ことで解決しました。

    この記事で扱うこと

    WAFによる誤検知、二分探索を使った原因の特定、実体参照によるすり抜けがなぜ効かないのか、そしてWordPressのインポート機能を使った解決。技術記事を書く人ほど踏みやすい問題です。

    403だけが返ってくる

    記事をWordPressのREST APIに送ると、403が返りました。

    返ってきたもの
    status: 403
    body: (空。WordPressのエラー形式ですらない)

    ここに最初の手がかりがあります。WordPressが権限で拒否する場合、rest_cannot_create のようなコードを含むJSONを返します。中身が空の403は、WordPressに届く前に止められていることを意味します。

    直前まで同じ手順で5本の記事を投稿できていました。コードも認証も変えていません。変えたのは記事の中身だけです。

    どこが引っかかっているのかを探す

    本文は約13,000文字あります。どこが原因かを目で探すのは現実的ではありません。

    そこで二分探索を使いました。本文の前半だけを送ってみて、通れば原因は後半にあり、弾かれれば前半にある。これを繰り返して範囲を半分ずつ狭めていきます。13,000文字なら、14回ほどで場所が特定できます。

    やったこと(ブラウザのコンソールで実行)
    const ok = async (text) => {
      const res = await fetch('/wp-json/wp/v2/posts', {
        method: 'POST',
        credentials: 'same-origin',
        headers: { 'Content-Type': 'application/json', 'X-WP-Nonce': nonce },
        body: JSON.stringify({ title: 'probe', content: text, status: 'draft' })
      });
      return res.status === 201;
    };
    
    let lo = 0, hi = content.length;
    while (hi - lo > 16) {
      const mid = Math.floor((lo + hi) / 2);
      if (await ok(content.slice(0, mid))) lo = mid; else hi = mid;
    }
    console.log(content.slice(lo - 50, hi + 16));   // 境界の前後を表示

    結果はこうでした。

    const HEADING_PATTERN = 正規表現でHTMLの見出しタグを拾う行

    記事の中で紹介していた、見出しを抽出する正規表現です。WAFから見ると、HTMLタグを組み立てようとしている文字列=コード注入の試みに見えます。

    検証用のデータを残さない工夫

    上の関数は、投稿に成功した場合その投稿をすぐゴミ箱に入れています。二分探索は十数回の投稿を行うので、これをやらないと「probe」という記事が大量に残ります。調査のために本番環境を汚さないのは、調べる前に決めておくべきことです。

    すり抜けようとして、4回失敗した

    原因が分かったので、表示を変えずに検知だけ避ける方法を順に試しました。

    試したこと ねらい 結果
    バックスラッシュを数値文字参照に エスケープ記号を消す 失敗
    バッククォートも数値文字参照に コマンド置換に見える形を消す 失敗
    コード部分の記号をすべて数値文字参照に 記号の並びを根本から消す 失敗
    JSONではなくフォーム形式で送る 検査対象から外れることを期待 失敗

    3番目で分かったことが重要でした。WAFは実体参照を元に戻してから判定しています。

    これは考えてみれば当然です。攻撃者も同じ手を使うからです。&#60;script&#62; と書けば通ってしまうWAFには、防御の意味がありません。ブラウザが解釈する前の姿ではなく、解釈した後の姿で判定するのが正しい実装です。

    つまり、表示が同じである限り、エンコードを変えても結果は変わりません。目的が「表示は同じまま通す」ことである以上、この方向に出口はないと分かりました。

    ひとつだけ、通っていた経路があった

    行き詰まったところで、それまでの作業を振り返りました。

    記事の本文をブラウザに渡すために、13,000文字のJSONファイルをWordPressのメディアにアップロードしていました。そのアップロードは、一度も失敗していません。

    中身は同じです。同じ正規表現も、同じコードも入っています。それでも通っていました。

    送り方 中身 結果
    JSONの本文として送る 同じ 403
    フォームの項目として送る 同じ 403
    ファイルとして送る 同じ 成功

    このWAFは、フォームの入力値は検査するが、ファイルの中身は検査していないという動きをしていました。

    これは手抜きではなく、設計上の判断だと思われます。アップロードされるファイルは画像や動画やアーカイブで、中身は任意のバイト列です。すべてを攻撃パターンで検査すれば、正常なファイルが大量に誤検知されます。

    正規の道具が、すでに用意されていた

    ファイルなら通る。ではファイルとして記事を投入する方法はあるか。

    あります。WordPressのインポート機能です。サイト間で記事を引っ越すための仕組みで、記事をWXR(WordPress eXtended RSS)という形式のXMLファイルとして読み込みます。

    article6.xml(抜粋)
    <item>
      <title>読む体験をつくる</title>
      <dc:creator><![CDATA[sakurai_dev]]></dc:creator>
      <content:encoded><![CDATA[ ここに記事本文のHTML ]]></content:encoded>
      <wp:post_name><![CDATA[reading-experience]]></wp:post_name>
      <wp:status><![CDATA[publish]]></wp:status>
      <wp:post_type><![CDATA[post]]></wp:post_type>
      <category domain="category" nicename="tech"><![CDATA[技術系]]></category>
      <category domain="post_tag" nicename="react"><![CDATA[React]]></category>
    </item>

    本文は CDATA という区画に入れます。この中身はXMLとして解釈されないので、HTMLタグをそのまま書けます。

    「ツール → インポート → WordPress」からこのファイルをアップロードすると、記事・カテゴリ・タグがまとめて作られます。一度で通りました。

    抜け道ではない

    この方法は、WAFをだましているわけではありません。WordPressが元から用意している正規の移行手段を、そのまま使っただけです。防御は一切弱めていません。<script>alert(1)</script> は今も遮断されたままです。

    WAFを無効にしなかった理由

    途中、WAFを一時的に無効にして試したことがあります。実際、正規表現の行は通るようになりました。しかし記事全体はまだ弾かれ、<script> も遮断されたままでした。防御が複数の層で構成されていたためです。

    ここで「全部無効にする」という選択もありました。しかし、それはやめました。

    理由は単純です。この問題は今後も繰り返し起きます。技術記事を書く以上、本文にコードが入るのは避けられません。次に何が引っかかるかは予測できません。そのたびにWAFを無効にしていたら、いずれ「戻し忘れ」が起きます。

    作業のたびに防御を外す運用は、いつか必ず外したままになります。人間の注意力に頼る仕組みは、長く続けると必ず破れます。防御を触らずに済む経路が見つかったなら、そちらを選ぶべきです。

    今回の学び

    まず、空の403は「届いていない」という意味だということ。アプリケーションが返すエラーには、たいてい理由が書いてあります。理由の無いエラーは、アプリケーションより手前で止められています。どこを調べるべきかが、これで決まりました。

    次に、手作業で探さないこと。13,000文字から原因の1行を見つけるのに、二分探索なら14回で済みます。目で追えば見落としますし、時間もかかります。範囲を半分ずつ狭める方法は、原因が1か所に絞れる問題ならほぼ常に使えます。

    そして、同じ内容でも、渡し方が変われば結果が変わるということ。今回いちばんの発見はこれでした。中身をどう変形しても通らなかったものが、経路を変えた瞬間に通りました。行き詰まったら、変える対象を「中身」から「経路」に移す。この視点は他の場面でも使えます。

    最後に、防御を弱める解決を最後の手段にすること。無効にすれば即座に解決しますが、それは問題を先送りしているだけです。しかも「一時的に」で済んだためしがありません。遠回りに見えても、防御を維持したまま通る道を探す価値はありました。

  • 読む体験をつくる — 目次の自動生成から読了状態の保存まで

    読む体験をつくる — 目次の自動生成から読了状態の保存まで

    記事を5本公開したあと、読む側の体験を作り込みました。目次の自動生成、追従する目次、読了状況の表示と保存、スマートフォンのメニュー、読了目安の時間。あわせて、トップページの見た目も見直しています。

    この記事は、その実装記録です。ただ機能を並べるのではなく、採用しなかった案と、その理由を中心に書きます。何を作ったかより、なぜそう決めたかのほうが、後から読んで役に立つためです。

    この記事で扱うこと

    HTML文字列からの見出し抽出、Reactのサーバーコンポーネントとクライアントコンポーネントの境界、IntersectionObserverによる現在位置の判定、localStorageとハイドレーションのずれ、そして「運用で止まらない設計」という考え方。最後に、生成AIが使えない環境でサムネイル画像を作った方法にも触れます。

    手書きの目次は、いつか必ず壊れる

    これまでの記事には、本文の先頭に目次を手書きしていました。見出しと同じ内容を、リンク付きのリストとしてもう一度書いていたわけです。

    この方式には構造的な弱点があります。同じ情報が2か所にあるということです。見出しを1つ足したら目次にも足す、順番を入れ替えたら目次でも入れ替える。どちらかを忘れた瞬間、目次と本文がずれます。

    しかも厄介なのは、ずれていても画面上は正常に見えることです。目次に無い節があっても、リンク先が消えていても、ページは普通に表示されます。壊れていることに気づく手がかりがありません。

    本文から機械的に作れば、この不整合は原理的に起こらなくなります。情報の出どころが1つになるからです。

    HTMLは「ただの長い文字列」でしかない

    実装で最初に理解しておく必要があるのは、記事本文がどういう形でReactに届くかです。

    WordPressから返ってくる本文は、HTMLの文字列です。React側から見ると、これはコンポーネントの木ではなく、ただの長いテキストです。<h2> が何個あるかを数えることも、その中身を取り出すこともできません。React上の要素ではないからです。

    したがって、見出しを拾うには文字列のまま解析するしかありません。

    src/lib/toc.ts
    // h2 と h3 を拾う。後方参照を使い、開始タグと同じ種類の閉じタグに対応させている
    const HEADING_PATTERN = /<(h2|h3)([^>]*)>([\s\S]*?)<\/\1>/gi;
    
    export function buildToc(content) {
      const toc = [];
      let autoIdCount = 0;
    
      const html = content.replace(HEADING_PATTERN, (whole, tag, attrs, inner) => {
        const text = toPlainText(inner);
        if (!text) return whole;
    
        // 既に id があるなら、その id をそのまま使う
        const existingId = extractId(attrs);
        const id = existingId ?? `section-${++autoIdCount}`;
    
        toc.push({ id, text, level: tag.toLowerCase() === "h3" ? 3 : 2 });
    
        if (existingId) return whole;
        return `<${tag}${attrs} id="${id}">${inner}</${tag}>`;
      });
    
      return { html, toc };
    }

    ここで意識したのは、既にidが振ってある見出しは、そのidを使い回すという点です。

    新しく連番を振り直すほうが実装は簡単ですが、それをやると公開済み記事のアンカー付きURLが全部変わります。外部から /blog/xxx#why-headless のようなリンクを張られていた場合、それが黙って壊れます。URLは公開した瞬間に他人が持つ資産になるので、こちらの都合で変えてはいけません。

    正規表現でハマった箇所

    どの記事に手書きの目次が入っているかを調べたとき、5本中3本しか該当しないという結果が出ました。原因は g フラグ付きの正規表現で test() を繰り返したことです。この場合、前回の検索位置が記憶されていて、1回おきに失敗します。件数が想定と違ったので調べ直して気づきました。数が合わないときは、だいたい数え方のほうが間違っています。

    サーバーで作れないものがある

    目次を追従させ、いま読んでいる節をハイライトし、読了状況をバーで示す。これらはすべてスクロール位置に依存します。

    ここで、Next.jsのApp Routerにおける重要な区別が出てきます。ページは既定でサーバーコンポーネントとして動きます。サーバー側でHTMLを組み立てて返すため、ブラウザに送るJavaScriptが減り、表示が速くなります。

    しかしサーバーが作れるのは「最初の1枚」だけです。スクロール位置は、そのあとブラウザの中で刻々と変わる値で、サーバーには存在しません。

    そこで、こうした部分だけをクライアントコンポーネント(ファイル先頭に "use client" と書く)に分けます。

    やりたいこと どちらで動かすか 理由
    本文から目次を抽出する サーバー 本文が手に入った時点で結果が決まる。ブラウザに解析処理を送る必要がない
    目次を表示し、開閉する クライアント 開いている・閉じているという状態を持つ
    いま読んでいる節を判定する クライアント スクロール位置はブラウザにしかない
    読了目安の時間を計算する サーバー 本文の文字数から決まる。何度計算しても同じ

    「取り出す」処理はサーバー、「見せる・動かす」処理はクライアント。この線引きを最初に決めておくと、迷いが減ります。

    スクロールのたびに全部測るのをやめる

    いま画面に見えている見出しを判定する方法として、最初に思いつくのはスクロールイベントです。スクロールのたびに、すべての見出しの座標を測って比べる。動きはします。

    ただしこの方法は、見出しが増えるほど重くなります。1本目の記事は見出しが26個あるので、スクロールのたびに26回の座標計算が走ることになります。スクロールイベントは1回のスクロール操作で何十回も発火するので、掛け算で効いてきます。

    ブラウザには、この用途のための仕組みが用意されています。

    src/components/TableOfContents.tsx
    const observer = new IntersectionObserver(
      (entries) => {
        const visible = entries
          .filter((entry) => entry.isIntersecting)
          .sort((a, b) => a.boundingClientRect.top - b.boundingClientRect.top);
    
        if (visible[0]) setActiveId(visible[0].target.id);
      },
      {
        // 画面全体ではなく「上から80px〜画面の30%まで」の帯だけを対象にする
        rootMargin: "-80px 0px -70% 0px",
        threshold: 0,
      },
    );
    
    headings.forEach((heading) => observer.observe(heading));

    IntersectionObserverは「この要素が画面に入った・出た」をブラウザ側で判定して教えてくれる仕組みです。座標計算をこちらでやらないので、見出しが増えても負荷がほとんど変わりません。

    rootMargin の指定には意味があります。画面全体を対象にすると、見出しが画面の下端に入った瞬間から「いま読んでいる節」と判定されてしまい、実際に読んでいる場所とずれます。上から80pxのあたりから画面の30%までという帯に絞ることで、体感に合わせています。

    進捗バーは、どこに置くかで意味が変わる

    読了状況を示すバーは、最初、画面の最上端に固定して表示していました。よく見かける形です。

    しかし実際に置いてみると、2つ問題がありました。ヘッダーと重なって見づらいこと。そして何の進捗なのかが、見ただけでは分からないことです。細い線が伸び縮みしているだけでは、それが読了率なのか、読み込み中の表示なのか、判断できません。

    そこで目次の中に移し、上に文字を添えました。

    目次パネルの表示
    読了まで              あと 58%
    ━━━━━━━━━━━━━━━━━━━━━
    
    目次
      まず全体像
      なぜヘッドレスにしたのか
      ...

    目次という「記事全体の地図」と同じ枠に入ることで、バーが何を表しているかが説明なしに伝わります。同じ部品でも、置く場所で有用にも無意味にもなります。

    数値は「読んだ割合」ではなく「残りの割合」にしました。読み手が知りたいのは、通ってきた距離ではなく、あとどれくらいで終わるのかという見通しだと考えたためです。

    細かいが効く指定

    パーセントの数字には tabular-nums という指定を入れています。数字の幅を揃えるCSSで、これが無いと 9% から 10% に変わる瞬間に桁が増え、文字の位置が横に揺れます。動くべきでないものが動くと、それだけで安っぽく見えます。

    自分の設計を取り下げた話

    読了状態をブラウザに保存し、次に開いたときも「読み終えた記事」と分かるようにしたい。そう考えました。

    最初は、やめておこうと考えました。理由はこうです。ページを開き直した直後、読者は記事の先頭にいます。そこで進捗バーが空なのに文字だけ「読み終えました」と出ていたら、表示同士が食い違って見えます。バーの仕事は現在位置を示すことなので、そこに過去の履歴を混ぜると、どちらの情報も信用されなくなる——そう考えました。

    この見立て自体は間違っていなかったと思います。ただし、そこから引き出した結論が違っていました。

    最終的に採用したのは、読了済みならバーを満杯の緑で固定するという形です。現在位置の表示をやめ、「この記事は読み終えている」という状態の表示に切り替えます。スクロールを戻しても「あと58%」には戻りません。

    src/components/ReadingProgress.tsx
    // 一度「読了済み」になったら、その表示のまま固定する。
    // スクロールを戻すたびに表示が行き来すると、
    // 読み終えたという事実が揺らいで見える。
    const [finished, setFinished] = useState(false);
    
    useEffect(() => {
      if (readBefore || remaining === 0) setFinished(true);
    }, [readBefore, remaining]);

    私が見落としていたのは、読み手にとって、読み終えたという事実のほうが、いま何%の位置にいるかより重要だという点でした。矛盾を避けようとして、優先順位の低いほうを守っていたことになります。

    設計の議論では「どちらが正しいか」より「どちらが読み手の関心に近いか」で決めるほうが、たいてい良い答えになります。

    サーバーが知らないことを表示する

    読了状態の保存先には、CookieではなくlocalStorageを選びました。

    Cookieは、そのドメインへのリクエストのたびに自動でサーバーへ送られます。読了状態はサーバーがまったく使わない情報なので、毎回送るのは通信の無駄です。容量も4KB程度しかなく、記事が増えると窮屈になります。localStorageはブラウザ内に閉じた保存領域で、サーバーには送られず、容量も数MBあります。

    ただしlocalStorageを使うと、必ずハイドレーションのずれという問題に当たります。

    ハイドレーションとは、サーバーが作ったHTMLに対して、ブラウザ側のReactが「同じものを作れるか」を確認しながら操作を結びつけていく処理のことです。ここで両者の出力が食い違うと、Reactが警告を出します。

    読了状態はまさに食い違います。サーバーはその人が記事を読んだかどうかを知りません。localStorageはブラウザの中にしか無いからです。したがってサーバーは常に「未読」として描き、ブラウザは「既読」と判断します。

    src/components/ReadBadge.tsx
    export default function ReadBadge({ slug }) {
      const [read, setRead] = useState(false);
    
      // 最初の描画では必ず false のまま。
      // 画面に出たあと(useEffect の中)で初めて localStorage を読む。
      // こうするとサーバーとブラウザの初回の出力が一致する。
      useEffect(() => {
        setRead(hasRead(slug));
      }, [slug]);
    
      if (!read) return null;
      return <span>読了済み</span>;
    }

    印が一瞬遅れて出ることになりますが、これが正しい作りです。サーバーが知り得ない情報は、サーバーの描画に混ぜてはいけません。

    もうひとつ、localStorageの読み書きは例外を投げることがあります。プライベートモードやブラウザの設定で無効化されている場合です。全ての操作を try/catch で囲み、失敗したら「記録しないだけ」で動き続けるようにしました。付加的な機能のために、記事そのものが表示できなくなってはいけません。

    押しても同じものが出てくるリンクを消す

    ここからは、実装というより判断の話です。

    実績のカードは、これまでカード全体が詳細ページへのリンクになっていました。ところが実際に運用してみると、詳細ページで増える情報は担当役割・実施期間・関連リンクの3つだけで、本文は一覧と同じものが出るだけでした。

    押しても、ほぼ同じ内容がもう一度出てくるリンクは、読み手の時間を奪います。そこで、詳細ページにしか無かった項目をカードに取り込み、遷移そのものを無くしました。情報を削るのではなく、1階層に畳んで見せる形です。

    外部サイトへのリンクだけは残しています。これは「同じ内容の別ページ」ではなく、実物を見に行く導線なので、押す価値があります。

    遷移を消したあとの後始末

    どこからもリンクされなくなった詳細ページは、URLを直接叩けばまだ表示されます。これは同じ内容が2つのURLで見られる状態で、検索エンジンからは重複コンテンツとして扱われます。使わないページは、リンクを外すだけでなく削除まで行う必要があります。

    情報を持たない画像は、面積の無駄になる

    トップページの実績カードには、鮮やかな抽象イラストが載っていました。オレンジ、紫、緑、青。見た目には賑やかです。

    しかしその画像は、実際に作ったものではなく、汎用のダミーUIやグラフのイラストでした。読み手はまず画像を見ますが、そこから得られるものが何もありません。カード内で最も面積を取っている要素が、最も情報量が少ない状態でした。

    さらに、サイト全体の配色方針と衝突していました。設定ファイルには「ニュートラルなグレー基調 + アクセント1色」と書いてあるのに、画面には5色以上が同時に出ていました。方針と実装がずれていたわけです。

    画像を外し、カテゴリのアイコンと名前を置く帯に置き換えました。同時に、本文側にあった重複したカテゴリ表示も削除しています。画像とアイコンで同じことを2回言っていた状態が、これで解消されました。

    色は、意味の違いを示すときに使う

    スキルの習熟度バーは、スキルごとに違う色が割り当てられていました。これも青1色に統一しました。

    判断の根拠はシンプルです。色の違いに意味が無かったからです。HTMLが橙でCSSが青であることに、何の情報もありません。差を表しているのはバーの長さです。色を外しても、失われる情報は1つもありませんでした。

    逆に、色を残した箇所もあります。読了済みの印を緑にしたのは、「未読と既読」という意味の違いを示しているからです。

    運用で止まる仕組みは、優れていても採用しない

    記事のサムネイル画像を作る段になって、いちばん考えさせられた判断がこれでした。

    最初の案には、記事ごとに内容を表すアイコンと、SERIES 01〜05という通し番号を入れていました。見た目は整っていました。

    ところが、並べてみて気づきました。この形は運用する際に困ります。

    連番のほうは分かりやすい問題です。番号は「順序」という情報を画像に焼き付けます。記事を1本追加した瞬間、あるいは途中に差し込んだ瞬間、番号は嘘になります。画像に焼いた情報は後から直せません。

    アイコンのほうは、もう少し見えにくい問題です。絵柄と内容は対応していたので、機能としては悪くありませんでした。問題は、記事を書くたびに「この記事のアイコンは何にするか」を決める作業が発生することです。これは判断を要する作業で、数分では終わりません。そして決めきれずに保留した記事は、アイコンが空白のまま公開されます。

    ここから引き出せる原則は、こうです。運用が止まる原因になる仕組みは、機能として優れていても採用すべきではない。更新されなくなったブログは、装飾が丁寧なことより痛手が大きいからです。

    改訂後のサムネイルで、記事ごとに決める要素はカテゴリとタイトルとサブタイトルだけになりました。カテゴリとタイトルはWordPressに入力済みなので、実質的に新しく決めるのはサブタイトルの1行です。

    あわせて、タイトルの文字数に応じて文字サイズを自動で切り替えるようにしました。長いタイトルのときに手で調整しなくて済みます。運用で困る箇所は、あらかじめ潰しておきます。

    生成AIが使えない環境で画像を作る

    サムネイルは当初、画像生成AIで作る想定でした。しかし使おうとした環境では画像生成が利用できず、別の方法を探すことになりました。

    次に試したのがストックフォトの検索です。結果は芳しくありませんでした。「ヘッドレスCMSの構成」「デプロイでハマった話」といった内容に対して返ってきたのは、住宅の設計図、青い積み木、白い展示台。この手の技術記事の内容に対応する写真は、そもそも存在しないという性質の問題でした。

    これを貼れば、さきほど実績カードから外したのとまったく同じ状態を作り直すことになります。

    そこで採った方法が、HTMLとCSSでデザインして、ヘッドレスブラウザで画像として書き出すというものです。

    サムネイル生成スクリプト(抜粋)
    const browser = await chromium.launch();
    const page = await browser.newPage({ viewport: { width: 1200, height: 630 } });
    
    for (const article of ARTICLES) {
      await page.setContent(html(article), { waitUntil: "load" });
      await page.screenshot({ path: article.file });
    }
    
    await browser.close();

    ブラウザを画面なしで動かし、作ったHTMLを表示させ、その画面を撮る。それだけです。この方式には、絵を描く方法として見たときに明確な利点があります。

    サイトのヒーローとまったく同じCSS(グラデーション、グリッド、ロゴ)を使えるので、デザインが自然に揃います。タイトルは文字として載るため、内容と必ず一致します。そして修正がききます。タイトルを変えたらコードを1行直して再実行するだけで、全部作り直せます。

    サイズは1200×630にしました。ブログ一覧のカードだけでなく、SNSで共有されたときのOGP画像としてもそのまま使える寸法です。

    作業中に踏んだ罠

    実装そのものより時間を取られた箇所を、3つ記録しておきます。どれも「コードは正しいのに動かない」という形で現れました。

    1. 見ていたサーバーが違った

    変更を反映したのに画面が404のまま、という状態が続きました。原因はターミナルの警告文にありました。

    見落としていた1行
    ⚠ Port 3000 is in use, trying 3001 instead.

    前に起動した開発サーバーが完全に止まっておらず、ポート3000を掴んだままでした。新しいサーバーは3001で起動しており、私たちが見ていた3000は、古い設定で動いていた別のサーバーだったわけです。

    2. 設定ファイルを読まないツールがあった

    GraphQLの型を再生成しようとして、何度やっても失敗しました。設定はこう書かれています。

    codegen.ts
    schema: process.env.NEXT_PUBLIC_WORDPRESS_API_URL ?? "http://localhost:8080/graphql"

    環境変数は .env.local に書いてあります。しかし.env.local を自動で読み込むのはNext.jsであって、型生成ツールではありません。環境変数が空のまま右側にフォールバックし、起動していないローカルWordPressを見に行って失敗していました。

    「同じフォルダにある設定ファイルは、全部のツールが読んでくれる」と思い込んでいると、この種の問題は見つかりません。

    3. 古いサイトが表示され続けた

    本番サイトを開いたら、更新前の古いデザインが出ました。一瞬デプロイの失敗を疑いましたが、URLに意味のないパラメータを付けて開き直すと、新しいサイトが表示されました。ブラウザのキャッシュです。

    共通しているのは、3つとも「コードの問題」ではなかったという点です。コードを疑って読み直しても答えは出ません。何かおかしいと感じたら、コードの外側——どのサーバーを見ているか、どの設定が読まれているか、いつのデータを見ているか——を先に確認するほうが早いことが多いです。

    今回の学び

    実装の話として3つ、判断の話として2つ、残しておきます。

    実装では、同じ情報を2か所に持たないこと。目次を手書きしていたのは、見出しという情報を二重に持っていた状態でした。片方から機械的に作れば、ずれようがありません。

    次に、サーバーが知り得ない情報は、サーバーの描画に混ぜないこと。localStorageの中身はブラウザにしかありません。初回は何も出さず、画面に出てから読む。遠回りに見えて、これが正しい順序です。

    そして、仕組みに用意された道具を使うこと。スクロールのたびに全要素を測る代わりにIntersectionObserverを使う。自分で書けば動きますが、ブラウザ側で最適化されている処理には敵いません。

    判断のほうは、まず面積と情報量を一致させること。大きく見せているものほど、多くを伝えるべきです。意味のない画像が最大面積を占めていたら、それは削るべき対象です。

    最後に、運用で止まる仕組みは採用しないこと。これが今回いちばん考えさせられた点でした。作っている最中は、機能が多いほど良いものに見えます。しかし公開したあとに待っているのは、記事を書き続ける日々です。そのとき障害になるものは、どれだけ丁寧に作られていても負債になります。

  • 書いた記事をWordPressに届けるまで — CORS・nonce・CSSの壁

    書いた記事をWordPressに届けるまで — CORS・nonce・CSSの壁

    「作った」と「届いた」は違う

    ここまでの作業記録を記事にまとめ、HTMLファイルとして書き出しました。CSSも当て、ブラウザで開けばきちんと読める状態になっていました。私はそこで「記事の作成は完了した」と考えていました。

    しかし当然ながら、ファイルがローカルにあるだけでは誰も読めません。記事はブログに載って初めて記事です。成果物の形が合っていても、あるべき場所に届いていなければ完了ではない——今回いちばん効いた教訓はこれでした。

    そこで「HTMLファイル4本を、WordPressの投稿として登録する」という作業が発生します。手作業でコピー&ペーストすれば済む話に見えますが、1本あたり1万文字を超えるHTMLです。しかも今回の環境では、その素朴な方法が使えませんでした。この記事は、その受け渡し経路を作るまでの記録です。

    この記事で扱うこと

    ブラウザの同一オリジンポリシー(CORS)、WordPressのREST APIとnonce、アップロード可能なファイル形式の判定、React(Next.js)で外部HTMLを表示するときのCSS設計、そして公開後の検証方法。どれも「WordPressとNext.jsをつなぐ」構成では避けて通れない話です。

    通せる経路を探す

    状況を整理します。記事のHTMLは手元の作業環境にあり、WordPressの管理画面はブラウザで開いています。この2つの間には直通の道がありません。

    考えられる経路を順に試しました。

    案 やり方 結果
    1 GitHubのファイルURLをブラウザから直接読み込む 失敗。リポジトリが非公開なうえ、別ドメインなのでCORSで弾かれる
    2 作業環境から直接WordPressのAPIを叩く 失敗。作業環境からの外向き通信が制限されている
    3 記事本文をそのままスクリプトに書き込んで実行する 理屈上は可能。ただし4本で約5万文字。引用符やバックスラッシュのエスケープを1文字でも間違えると壊れる
    4 メディアライブラリにファイルをアップロードし、そのURLから読む 最初は失敗。原因の切り分けに時間を使った(後述)

    最終的に採用したのは、この4案のどれでもない5番目の方法でした。ただしそこにたどり着くには、まず1番の失敗が何を意味しているかを理解する必要があります。

    なぜブラウザは他所のデータを読ませないのか

    案1で出たエラーは Failed to fetch でした。ファイルが無いのでも、通信ができないのでもありません。ブラウザが意図的に読み取りを止めています。

    ブラウザには同一オリジンポリシーという原則があります。オリジンとは「プロトコル+ドメイン+ポート」の組のことで、https://cms.kisaku.site と https://github.com は別のオリジンです。原則として、あるオリジンのページで動くJavaScriptは、別のオリジンのデータを読めません。

    なぜそんな制限があるのか。もし制限が無ければ、こういうことが起きます。

    悪意のあるサイトで動くJavaScript(もし制限が無ければ成立してしまう)
    // 訪問者がネットバンクにログイン済みなら、
    // Cookieが一緒に送られて「本人のリクエスト」として通ってしまう
    const res = await fetch('https://bank.example.com/api/balance', {
      credentials: 'include'
    });
    const data = await res.json();   // 残高が読めてしまう
    send_to_attacker(data);

    つまり同一オリジンポリシーは、「ログイン状態を勝手に借用して他所のデータを盗む」ことを防ぐための仕組みです。CORS(Cross-Origin Resource Sharing)は、その原則に対して「このオリジンからなら読ませてよい」とデータの提供側が明示的に許可を出すための仕組みです。許可を出すのは受け取る側ではなく渡す側だという点が重要で、だから今回のように相手がGitHubであれば、こちらの都合で許可を足すことはできません。

    よくある誤解

    「CORSエラーが出た=サーバーが落ちている/URLが間違っている」と考えてしまいがちですが、違います。リクエスト自体はサーバーに届いていて、レスポンスも返ってきています。ブラウザがそれをJavaScriptに渡さないだけです。curl で同じURLを叩くと普通に取得できるのは、curlにはこの制限が無いからです。

    ファイル選択欄を通り道にする

    ここで発想を変えます。ブラウザが「別のオリジンから取ってくる」のを止めるなら、取ってこなければいい。利用者が自分の意思でファイルを選んで渡す経路なら、CORSは関係ありません。

    ファイル選択欄(<input type="file">)がまさにそれです。ここには、セキュリティ上の重要な非対称性があります。

    操作 可否 理由
    JavaScriptからファイルパスを設定する できない できてしまうと、サイト側が勝手に利用者のファイルを盗み出せる
    選ばれたファイルの中身をJavaScriptから読む できる 利用者が明示的に選んだファイルなので、同意があるとみなせる

    この「選ばれた後なら読める」を使います。ポイントは、ファイルをアップロードはしないことです。選択欄に入れるところまでで止め、中身だけをJavaScriptで読み出します。

    WordPress管理画面のコンソールで実行
    // 「メディアを追加」ページのファイル選択欄
    const input = document.getElementById('async-upload');
    const file  = input.files[0];
    
    // アップロードはしない。中身だけ読む。
    // File.text() はテキストとして読み出すメソッド(Promiseを返す)
    const text = await file.text();
    const posts = JSON.parse(text);
    
    console.log(posts.length);          // 4
    console.log(posts[0].content.length); // 11344

    記事4本をJSONの配列にまとめた1つのファイルを用意し、それを選択欄に入れて読み込みました。これで、5万文字のHTMLがブラウザのメモリ上に乗ります。CORSも通信も介在しません。

    この方法の良いところ

    メディアライブラリに中継用ファイルが残りません。「サーバーに置いてから読む」方式だと、用が済んだあとのファイルが公開状態で残り続けます。今回のように一度きりの受け渡しでは、置かずに済ませるほうが後始末が要りません。

    「権限がありません」の正体

    この方法にたどり着く前に、案4(メディアにアップロードしてから読む)を試していました。そこで出たのがこのエラーです。

    このファイルタイプをアップロードする権限がありません。

    管理者としてログインしているのに「権限がありません」と言われる。素直に読むと「WordPressが .txt を受け付けない設定になっている」と解釈したくなります。しかし調べると、WordPressは標準で text/plain を許可しています。話が合いません。

    そこで、同じことをREST API経由で試しました。小さなファイルを作って投げてみます。

    許可されている形式を実際に確かめる
    const form = new FormData();
    form.append('file', new Blob(['hello'], {type: 'text/plain'}), 'test.txt');
    
    const res = await fetch('/wp-json/wp/v2/media', {
      method: 'POST',
      credentials: 'same-origin',
      headers: {'X-WP-Nonce': nonce},
      body: form
    });
    console.log(res.status);   // 201 → 作成成功

    201が返りました。.txt は問題なくアップロードできる。つまりエラーの原因はファイル形式ではありませんでした。管理画面のフォームを操作する過程で、フォームに埋め込まれていたnonceが本来の組み合わせから外れてしまい、WordPressが「この操作は正当な経路から来ていない」と判断していたのです。

    nonceとは何か

    nonceは “number used once” の略で、その操作が正規の画面から、本人の意思で行われたことを示す使い捨ての合言葉です。Cookieだけで認証していると、こういう攻撃が成立してしまいます。

    CSRF(クロスサイトリクエストフォージェリ)の例
    <!-- 攻撃者のページ。訪問者がWordPressにログイン済みだと…… -->
    <form action="https://example.com/wp/wp-admin/user-new.php" method="post">
      <input name="user_login" value="attacker">
      <input name="role" value="administrator">
    </form>
    <script>document.forms[0].submit();</script>

    Cookieはドメインに対して自動で送られるので、リクエストは「ログイン中の管理者からの正当な要求」に見えてしまいます。nonceがあると、攻撃者はその値を知り得ないため、この形の攻撃は成立しません。

    ややこしいのは、WordPressのnonceは用途ごとに別物だという点です。管理画面のフォームに埋まっているnonceと、REST APIが要求するnonceは別で、片方をもう片方に使うと弾かれます。

    用途 取得方法 渡し方
    管理画面のフォーム送信 フォーム内の hidden 項目(_wpnonce) フォームの一部として送信
    REST API wpApiSettings.nonce、または admin-ajax.php?action=rest-nonce X-WP-Nonce ヘッダ

    最初、私はページのHTMLから正規表現で10桁の16進数を拾ってnonceにしていました。当然これは別用途のnonceを掴むことがあり、rest_cookie_invalid_nonce という403が返ります。確実な取り方は次のとおりです。

    REST API用のnonceを確実に取る
    // WordPressが専用に用意しているエンドポイント。
    // 管理画面にログインしていれば、有効なnonceを文字列で返す。
    const nonce = (await fetch('/wp/wp-admin/admin-ajax.php?action=rest-nonce', {
      credentials: 'same-origin'
    }).then(r => r.text())).trim();
    切り分けの考え方

    エラーメッセージは「何が起きたか」を教えてくれますが、「なぜ起きたか」は教えてくれません。「権限がありません」を額面どおり受け取っていたら、許可形式を増やす設定変更に進んでいたはずです。実際の原因は認証の受け渡しでした。別の経路で同じことを試して結果が変わるなら、原因は自分が疑っていた場所には無い——これは今回いちばん役に立った切り分け方でした。

    REST APIで下書きを作る

    本文がブラウザ上に乗り、有効なnonceも手に入りました。あとは投稿を作るだけです。

    投稿を下書きとして作成する
    const post = posts[0];
    
    const res = await fetch('/wp-json/wp/v2/posts', {
      method: 'POST',
      credentials: 'same-origin',
      headers: {
        'Content-Type': 'application/json',
        'X-WP-Nonce': nonce
      },
      body: JSON.stringify({
        title:      post.title,
        content:    post.content,
        status:     'draft',   // いきなり公開しない
        categories: [11]       // 「技術系」カテゴリのID
      })
    });
    
    const created = await res.json();
    console.log(res.status, created.id);   // 201 66

    status を draft にしているのは意図的です。いきなり publish にすると、表示が崩れていた場合に崩れた状態が世に出ます。下書きなら、確認してから公開できます。取り返しのつく順番で進めるというだけの話ですが、効果は大きいです。

    保存されたものを疑う

    201が返ったから成功、とはしませんでした。WordPressには wp_kses_post() という仕組みがあり、投稿本文から危険なタグや属性を削り落とすことがあります。今回の記事は class 属性に強く依存しているので、これが削られると装飾が全部消えます。

    削られるかどうかは、投稿するユーザーが unfiltered_html という権限を持つかで決まります。単一サイトの管理者は持っていますが、それは「持っているはず」であって「確認した」ではありません。そこで、保存されたものを読み戻して元と突き合わせました。

    保存後の本文が元と一致するか確かめる
    // context=edit を付けると、加工前の生データ(content.raw)が返る
    const res = await fetch('/wp-json/wp/v2/posts/66?context=edit', {
      credentials: 'same-origin',
      headers: {'X-WP-Nonce': nonce}
    });
    const saved = await res.json();
    
    console.log(saved.content.raw === post.content);       // true
    console.log((saved.content.raw.match(/<pre/g) || []).length);  // 12
    console.log(saved.status, saved.categories);           // draft [11]

    context=edit を付けるのがポイントです。これを付けないと表示用に整形された content.rendered しか返らず、元と比べても差が出てしまいます。生データ同士で比較して初めて「1文字も失われていない」と言えます。

    スラッグを先に整える

    公開する前に、URLの末尾になるスラッグを英語に変えました。日本語タイトルのまま公開すると、スラッグも日本語になり、URLがパーセントエンコードされて非常に長くなります。

    スラッグを後から変えるとリンクが切れる
    // 日本語スラッグの実際の姿
    /blog/%E3%81%AA%E3%81%9C%E3%81%93%E3%81%AE%E6%A7%8B%E6%88%90...
    
    // 変更後
    /blog/headless-wordpress-nextjs-architecture

    これを公開前にやるのには理由があります。公開後にスラッグを変えると、それまでのURLが404になります。SNSで共有されていれば、そのリンクは死にます。URLは公開した瞬間に「他人が持つ資産」になるので、後から変えられる前提で設計してはいけません。

    CSSが当たらない

    記事を1本公開して、フロント(Next.js側)で見てみると、文章は出るものの装飾が一切効いていませんでした。コードブロックは白背景のただの文字、補足ボックスも普通の段落です。

    原因は2つ重なっていました。

    1. className は流し込んだHTMLの中には届かない

    WordPressの本文は、React側では次のように表示しています。

    frontend/src/app/blog/[slug]/page.tsx
    <div
      className="wp-content mt-8 rounded-2xl bg-white p-6"
      dangerouslySetInnerHTML={{ __html: post.content }}
    />

    dangerouslySetInnerHTML は「このHTMLを解釈せずそのまま入れる」という指定です。中身はReactのコンポーネントではないので、Reactが管理する仕組み(className を渡す、コンポーネントを差し込む)は一切届きません。外側の div にどれだけクラスを足しても、内側の h2 や pre には影響しません。

    したがって、CSS側で「この箱の中の要素」として受けるしかありません。

    2. Tailwindが標準のスタイルを消している

    Tailwind CSSにはpreflightという機能があり、読み込むと h2 の文字サイズや p の余白といったブラウザ標準のスタイルを全部リセットします。ブラウザ差をなくすための仕組みですが、外部から流し込んだHTMLには致命的で、見出しと本文が同じ見た目になります。

    この2つをまとめて解決する形が、こうなります。

    frontend/src/app/globals.css
    .wp-content {
      /* 色は変数にまとめる。調整を1か所で済ませるため */
      --code-bg: #1c2128;
      --line:    #e3e6ea;
    
      line-height: 2;    /* 日本語は行間を広く取ると格段に読みやすい */
      font-size: 17px;
    }
    
    /* 装飾ではなく「上の余白」で階層を出す。
       線や色を足すより、空白のほうが読み手には強く効く */
    .wp-content h2 {
      font-size: 1.5rem;
      font-weight: 700;
      margin: 4.5rem 0 1.5rem;
      scroll-margin-top: 1.25rem;   /* 目次から飛んだとき上端に貼り付かない */
    }
    
    /* コードは濃色にして「ここは読み物ではない」と視覚的に伝える */
    .wp-content pre {
      background: var(--code-bg);
      color: #dfe3e8;
      border-radius: 8px;
      padding: 1.1rem 1.25rem;
      overflow-x: auto;   /* 折り返さない。折り返すとコードの構造が壊れる */
    }
    
    /* スマホで表がはみ出すのを防ぐ。
       表そのものではなくラッパーをスクロールさせるのがポイント */
    .wp-content .table-wrap { overflow-x: auto; }
    なぜ prose(Tailwind Typography)を使わないのか

    Tailwindには @tailwindcss/typography という、まさにこの用途のプラグインがあります。導入すれば見出しや段落は一発で整います。今回それを使わなかったのは、この記事群が .note や .code-block といった独自のclassを使っており、そこは結局自分で書く必要があるためです。半分プラグイン・半分自前だと、どちらに何が書いてあるか分からなくなります。既製品を入れるかどうかは「どこまで賄えるか」で決めるのが良さそうです。

    公開後の確認項目

    公開したあと、次の項目を確認しました。「見た目が合っていそう」で終わらせないための一覧です。

    確認すること 方法 なぜ見るのか
    一覧ページに出ているか ブログ一覧のリンクにスラッグが含まれるか 個別ページが正しくても、一覧に出なければ誰にも見つからない
    個別ページが200を返すか fetch(url) のステータス 404や500でないこと。スラッグの設定ミスはここに出る
    本文が入っているか HTML内に wp-content の箱があるか 取得に失敗しても、ページ自体は200で返ることがある
    HTMLがエスケープされていないか &lt;h2&gt; のような文字列が本文に出ていないか どこかでエスケープが挟まると、記事全体がタグの羅列になる
    CSSが実際に効いているか getComputedStyle() で計算後の値を見る 目視だと「効いているように見える」で通してしまう
    CSSが本当に適用されているかを値で確かめる
    const box = document.querySelector('.wp-content');
    const pre = box.querySelector('pre');
    
    console.log(getComputedStyle(pre).backgroundColor);
    // "rgb(28, 33, 40)" ← 指定した --code-bg と一致
    
    console.log(getComputedStyle(box).lineHeight);
    // "34px" ← 17px × 2.0。行間の指定も効いている

    getComputedStyle() は、CSSの継承や優先順位をすべて解決したあとの最終的な値を返します。「スタイルシートには書いたが、より強い指定に負けていた」というよくある失敗が、これを見れば一発で分かります。目で見て確認すると、うっすら効いている状態を「効いている」と判断してしまいがちです。

    おまけ:rebaseが止まるとき

    CSSをコミットしようとしたとき、以前と同じところで詰まりました。

    よく出るエラー
    error: cannot pull with rebase: You have unstaged changes.

    rebaseは「自分のコミットを、取り込んだ最新の状態の上に載せ直す」操作です。作業中の未コミットの変更が残っていると、載せ直す途中でそれが失われる危険があるため、Gitは先に止まります。

    毎回 git stash と git stash pop を手で打っていたのですが、これを自動でやるオプションがあります。

    退避と復帰を自動でやる
    git pull --rebase --autostash
    
    # 内部でやっていること:
    #   1. 未コミットの変更を一時退避(stash)
    #   2. rebase を実行
    #   3. 退避したものを戻す(stash pop)

    今回のように「関係ない別ファイルの変更が手元に残っている」場面では、これで止まらずに済みます。

    今回の学び

    技術的な内容より先に、いちばん大きかったのは冒頭の話です。ファイルを作ったことと、それが読める場所にあることは別。今回は「記事を書く」という依頼に対して、HTMLファイルを渡した時点で完了だと考えてしまっていました。依頼した側から見れば、ブログに載っていなければ何も起きていないのと同じです。

    技術面では、次の3つが残りました。

    ひとつ目は、制約は迂回するのではなく、その意味を理解してから別の道を探すということ。CORSに阻まれたとき、抜け道を探すのではなく「なぜこの制限があるのか」を理解したことで、ファイル選択欄という筋の通った経路にたどり着けました。制限の理由が分かれば、その理由に反しない方法も見えてきます。

    ふたつ目は、エラーメッセージは症状であって原因ではないということ。「権限がありません」を額面どおり受け取っていたら、許可設定をいじる方向に進んでいました。別の経路で同じ操作を試し、結果が変わったことで、原因が別の場所にあると分かりました。

    みっつ目は、成功したという返事を信じないということ。201が返っても、中身が削られていないかは別問題です。保存されたものを読み戻して元と比較する。CSSは目で見ずに計算値で確認する。ひと手間ですが、この確認があるから「できました」と言い切れます。

  • 公開したあとの話 — 脆弱性検知と監視の仕組みを作る

    公開したあとの話 — 脆弱性検知と監視の仕組みを作る

    ポートフォリオサイトを本番公開したあと、運用のための仕組みを整えました。脆弱性の検知、稼働の監視、依存パッケージの更新です。

    公開までの記事は「動かすまで」の話でしたが、今回は「動き続けさせる」ための話になります。地味な作業ですが、初回の実行でいきなり実害のある問題が見つかったので、やっておいてよかったと思っています。

    公開したら終わり、ではなかった

    デプロイが終わった時点で、次のような状態でした。

    ・使っているnpmパッケージ 679個 の脆弱性 → 誰も見ていない
    ・WordPress本体・プラグインの更新       → 気付いたときに手で確認
    ・公開してはいけないファイルの置き忘れ   → 気付く手段がない
    ・サイトが止まったとき                  → 自分が見に行くまで分からない

    個人サイトなので、止まっても誰も困りません。それでも仕組みを入れたのは、実際に「置き忘れ」をやらかしていたからです。

    移行作業のときに、データベース全体が入った約62MBのバックアップファイルをサーバーに置きました。作業には必要でしたが、URLさえ分かれば誰でもダウンロードできる状態でした。中にはユーザー情報もパスワードのハッシュも入っています。

    これは移行の途中で自分で気付いて削除しましたが、気付かなければ置きっぱなしでした。同じことがまた起きないようにしたい、というのが動機です。

    やったこと1: 脆弱性の自動検知を入れる

    GitHubには Dependabot という機能が最初から用意されています。使っているパッケージの一覧を読み取り、既知の脆弱性データベースと突き合わせて教えてくれるものです。

    設定は3段階に分かれていて、順に有効化する必要があります。

    機能 役割
    Dependency graph 依存関係を解析する土台。これが無いと以下が動かない
    Dependabot alerts 脆弱性を検知して通知する
    Dependabot security updates 修正版へ上げるPRを自動で作る
    ポイント

    alerts だけだと「アラートは来るが誰も直さない」状態になりやすいです。security updates まで有効にして、修正案がPRの形で届くようにするのが実用的でした。人間がやるのは中身を見てマージするだけになります。

    あわせて .github/dependabot.yml という設定ファイルも置きました。これがあると、脆弱性の有無に関係なく定期的な更新PRも作られます。

    .github/dependabot.yml
    version: 2
    updates:
      - package-ecosystem: npm
        # Next.jsアプリはリポジトリ直下ではなく frontend/ にある
        directory: /frontend
        schedule:
          interval: weekly
        open-pull-requests-limit: 5
        groups:
          minor-and-patch:
            update-types: [minor, patch]
    つまずきやすい点

    directory: /frontend の指定が重要です。今回のリポジトリはルート直下にWordPressのファイルもあり、Next.jsは frontend/ の中にあります。ここを間違えると package.json が見つからず、Dependabotはエラーも出さずに何もしません。「設定したのに動かない」で悩む典型的なパターンです。

    やったこと2: 検知できない領域を自分で作る

    Dependabotは強力ですが、npmパッケージしか見ません。今回のサイトで実際に起きた問題を並べると、拾えるのは1つだけでした。

    実際に起きたこと Dependabotで拾えるか
    next に脆弱性 拾える
    バックアップファイルが誰でもダウンロード可能 拾えない
    SSL証明書がホスト名と不一致 拾えない
    CMSが落ちてサイトのデータが全部空 拾えない

    パッケージの脆弱性より、設定ミスや置き忘れのほうが実際には多かったわけです。そこで、残りをカバーする監視をGitHub Actionsで作りました。

    GitHub Actionsは、GitHubのサーバー上でコマンドを定期実行できる仕組みです。毎朝9時に動かし、問題があればSlackへ通知します。

    .github/workflows/security-audit.yml(抜粋)
    on:
      schedule:
        # 毎日 09:00 JST(cron は UTC なので 00:00 を指定)
        - cron: "0 0 * * *"
      workflow_dispatch:   # 手動実行もできるようにする

    チェックしているのは4領域です。

    1. npm依存パッケージ … npm audit の結果から high 以上を報告
    2. WordPress本体     … 導入バージョンと最新版を比較
    3. 公開ファイル       … 見えてはいけないURLを実際に叩いて確認
    4. 稼働とSSL証明書    … 表示・API応答・証明書の残り日数

    実際の失敗から作った監視項目

    この中に、教科書には出てこない項目をひとつ入れました。

    scripts/security-audit.mjs(抜粋)
    if (/まだ実績が登録されていません|まだ記事がありません/.test(html)) {
      report("high", "health", "サイトは表示されるがCMSのデータが取得できていない");
    }

    デプロイのときに、ビルドは成功しページも表示されるのに、データが1件も出ないという状態に数時間はまりました。HTTPステータスは200なので、普通の死活監視では検知できません。

    監視項目は、教科書からではなく自分が踏んだ失敗から作るほうが実用的になります。

    通知は異常時だけにする

    Slackへの通知は、問題があったときだけ送るようにしました。正常時は何も送りません。

    毎日「異常なし」が届くと、そのうち誰も読まなくなります。 通知は「届いたら必ず見る」状態を保つことが重要で、そのためには送る回数を絞る必要があります。

    初回実行でいきなり本物が出た

    作った監視を初めて動かしたところ、25件を検知しました。そして、その中に実害のある指摘が含まれていました。

    CRITICAL (exposure) /wp/readme.html が公開状態(200 / 7406バイト)

    readme.html はWordPressに最初から入っているファイルで、WordPressのバージョン番号が書かれています。

    これがなぜ問題かというと、攻撃する側にとって攻撃対象を絞り込むための情報だからです。「このサイトはWordPress 7.0.2だから、このバージョンに効く攻撃を試そう」と判断できてしまいます。

    削除すべきファイルなのですが、WordPressを更新するたびに復活します。だからこそ、一度消して終わりではなく定期チェックの対象にする価値があります。

    作った意味があった

    これはDependabotでは絶対に拾えません。パッケージの脆弱性ではなく、置き忘れだからです。移行のときの .wpress と同じ種類の問題が、まだ他にもあったということでした。

    誤報も出た(そして直した)

    同時に、誤検知も1件ありました。

    CRITICAL (exposure) /wp/wp-config.php が公開状態(200 / 0バイト)

    wp-config.php にはデータベースのパスワードが平文で書かれています。もし中身が読めるなら重大な問題です。

    ただ、よく見ると0バイトです。中身は漏れていません。PHPファイルはサーバー側で実行されてから結果が返るので、このファイルの場合は実行結果が空になります。アクセスできること自体は正常な挙動でした。

    私の判定ロジックが「ステータス200 = 公開されている」という単純な条件だったために起きた誤報です。本文まで読んでから判定するように直しました。

    scripts/security-audit.mjs(修正後)
    const res = await get(`${CMS}${path}`);
    if (res.status !== 200) continue;
    
    // 200が返っても中身が空なら「漏れていない」。
    // 例: wp-config.php はPHPとして実行され、出力は空になる。
    const body = await res.text();
    const bytes = new TextEncoder().encode(body).length;
    
    if (bytes === 0) {
      note(`${path} は200を返すが中身は空(問題なし)`);
      continue;
    }
    
    // ファイルの性質によって深刻度を変える
    const severity = /wp-config\.php|\.wpress$/.test(path) ? "critical" : "high";
    report(severity, "exposure", `${path} の中身が読める状態(${bytes}バイト)`);

    修正後、検知件数は 25件 → 23件 になりました。誤報1件と、削除した readme.html の1件が消えた形です。

    監視を作るときの原則

    監視は動かしてから調整するものです。最初から完璧を狙う必要はありません。ただし誤報を放置してはいけないのは重要で、誤報が続くと通知そのものが信用されなくなり、本物の警告まで無視されるようになります。

    更新PRの見分け方 ── セマンティックバージョニング

    Dependabotを有効にした直後、脆弱性51件を検知し、修正PRが8件作られました。

    これを全部そのままマージしてよいかというと、まったく違います。判断の基準になるのがセマンティックバージョニングという約束事です。

    16 . 3 . 0
    │    │   └── パッチ: バグ修正。動作は変わらない
    │    └────── マイナー: 機能追加。既存の動作は壊さない
    └─────────── メジャー: 破壊的変更あり。動かなくなる可能性がある

    この約束に従うと、左端の数字が変わらなければ、原則として壊れません。逆に左端が変わるものは、動作確認なしでマージしてはいけません。

    今回の8件を分類するとこうなりました。

    # 内容 種別 判断
    1 brace-expansion パッチ すぐマージ可
    2 js-yaml 4.3.0 → 4.3.1 パッチ すぐマージ可
    3 postcss 8.4.39 → 8.5.23 マイナー すぐマージ可
    4 minor-and-patch グループ マイナー すぐマージ可
    5 eslint-config-next 14 → 16 メジャー×2 #7とセット
    7 next 14.2.5 → 16.3.0 メジャー×2 #5とセット
    6 tailwindcss 3.4.4 → 4.3.3 メジャー 要注意
    8 graphql-request 6.1.0 → 7.4.0 メジャー 単独で検証

    セットで扱う必要があるもの

    eslint-config-next は Next.js とバージョンを揃える前提のパッケージです。片方だけ上げると噛み合いません。 #5 と #7 は必ず一緒にマージする必要があります。

    特に注意が要るもの

    Tailwind CSS の v3 → v4 は、設定の書き方が根本から変わります。これまで tailwind.config.ts に書いていた内容を、CSS側へ移す作業が必要です。

    怖いのは、ビルドが通っても見た目が崩れる可能性がある点です。「マージしたらエラーになる」なら気付けますが、「マージしたら静かにデザインが変わる」は気付きにくい。これは更新ではなく移行作業として、時間を取って扱うべきものです。

    なぜ一度に全部マージしないのか

    8件をまとめてマージすれば早く終わります。それをしなかった理由が2つあります。

    理由1: 問題が起きたとき原因が分からなくなる

    8件を同時に入れて表示が崩れたら、原因はどれでしょうか。切り分けるには結局1つずつ戻すことになり、余計に時間がかかります。

    変更は1つずつ、確認できる状態で入れる。 公開作業でSSL証明書の問題に数時間かけたのは、まさに「何が原因か切り分けられない状態」を作ってしまったからでした。

    理由2: マージするたびに他のPRが古くなる

    PRをマージすると package-lock.json というファイルが更新されます。すると残りのPRは古い状態のままになり、そのままではマージできません。

    Dependabotが自動で作り直してくれますが、少し時間がかかります。まとめられるものはまとめて処理するのが効率的です。

    今回の進め方

    安全な #1〜#4 を先に処理し、Dependabotが残りを作り直すのを待ってから、メジャーアップデートを1グループずつ扱う——という順序にしました。急がないものを急がないのも判断のうちです。

    確認項目チェックリスト

    今回の作業で使った確認項目をまとめておきます。次に同じことをするとき、これをなぞれば済むようにするためのものです。

    A. 依存パッケージを更新する前

    □ バージョン番号の左端が変わっていないか(メジャーか否か)
    □ セットで上げる必要のあるパッケージはないか
       (next と eslint-config-next のような組み合わせ)
    □ CI・プレビューのチェックが通っているか
    □ コンフリクトが出ていないか
    □ メジャーの場合、公式の移行ガイドを読んだか
    便利だった点

    VercelはPRごとにプレビュー環境を自動で作ります。本番と同じ環境でビルドが通るかを、マージ前に確認できました。「ビルドが通ることは確認済み」という状態でマージできるのは大きいです。

    B. マージした直後

    □ Vercelのデプロイが成功しているか
    □ トップページが表示されるか
    □ CMSのデータが実際に出ているか(空表示になっていないか)
    □ 主要ページが全部200を返すか
    □ 画像が表示されているか

    3つ目が特に重要です。ステータス200でも中身が空、という状態がありうることを、公開作業で学びました。ページが開けることと、中身が正しいことは別です。

    C. 定期的に確認すること(自動化済み)

    □ npm依存に high 以上の脆弱性がないか
    □ WordPress本体が最新か
    □ 公開してはいけないファイルが読めていないか
       ・移行用のバックアップ(.wpress)
       ・php.ini
       ・wp-config.php(中身が読める場合のみ)
       ・debug.log
       ・readme.html   ← WordPress更新のたび復活する
    □ ディレクトリ一覧が表示されていないか
    □ サイトが200を返すか
    □ ルートドメインが正しく転送されるか
    □ GraphQLがJSONを返すか
    □ SSL証明書の残り日数が14日を切っていないか

    証明書の閾値を14日にしたのには理由があります。Let’s Encryptは90日有効で、30日前から自動更新されます。つまり14日を切っている=自動更新が動いていないと判断できるわけです。

    D. 手作業でやること(自動化していない)

    □ WordPressプラグインの更新確認
    □ 管理者パスワードが十分に強いか
    □ 不要なプラグイン・テーマを削除したか
    □ ドメインの有効期限(切れるとサイト全体が止まる)
    □ 2要素認証の設定(GitHub / Vercel / サーバー)

    ドメインの有効期限は見落としやすい割に影響が大きい項目です。今回、作業中にたまたま管理画面で気付きました。

    今回の学び

    監視は既製品と自作を組み合わせる。 Dependabotだけでは今回の問題の4分の1しかカバーできませんでした。かといって全部自作するのも無駄です。既製品が得意な領域は任せ、残りを自分で埋めるのが現実的でした。

    監視項目は自分の失敗から作る。 「データが空なのに200を返す」という項目は、実際にはまったからこそ思いつきました。一般的な死活監視の教科書には出てきません。踏んだ失敗を監視項目に変換していくと、そのサイト固有の実用的な監視になっていきます。

    誤報は放置しない。 初回で誤報が1件出ました。誤報が続くと通知が信用されなくなり、本物の警告まで無視されるようになります。「オオカミ少年にしない」ことが、監視を維持する上でいちばん大事だと思っています。

    そして、急がないものを急がない。 8件のPRを前にすると全部片付けたくなりますが、メジャーアップデートは動作確認とセットです。急いで入れて壊すより、安全なものから順に入れて、残りは時間を取って扱う。作業を止める判断も作業のうちだと感じました。

    次回は、残っているメジャーアップデート(Next.js 16 と Tailwind CSS v4)に取り組む予定です。特にTailwindのv4は設定の書き方が変わるので、それなりの記事になりそうです。

  • 本番公開でつまずいた11のこと — 仕組みから解説

    本番公開でつまずいた11のこと — 仕組みから解説

    前回、ローカルで作ったサイトを本番公開するまでの記録を書きました。今回はその中で出てきた仕組みを、初めて触る人向けに整理して解説します。

    作業記録だけだと「こう直した」で終わってしまい、次に似た場面で応用が効きません。なぜそうなるのかが分かっていれば、症状が違っても同じ考え方でたどり着けます。前回の記事を読んでいなくても分かるように書きますが、実例は前回のものを使います。

    1. URLの「実体」と「転送先」は別物

    まず、いちばん基本的で、いちばん引っかかりやすい話から。

    ブラウザで https://example.com/admin/ を開いて、ページが表示されたとします。このとき「/admin/ にページがある」とは限りません。

    Webサーバーにはリダイレクト(転送)という仕組みがあります。「そのURLは別の場所に移ったので、こちらへどうぞ」とブラウザに指示するものです。指示を受けたブラウザは自動的に転送先へアクセスし直します。

    あなた: /admin/ をください
    サーバー: それは /wp/admin/ にあります(301 転送)
    ブラウザ: では /wp/admin/ をください(自動)
    サーバー: どうぞ(200 OK)
         ↓
    画面には「表示された」としか見えない

    この自動追従は普段は便利です。しかし構成を調べる目的では邪魔になります。私は実際にこれで誤解し、「WordPressはルートフォルダにある」と思い込んだまま作業を進めてしまいました。

    調べ方: 追従を切る

    ブラウザの fetch には、転送を追いかけない設定があります。

    await fetch('/admin/',     { redirect: 'manual' })  // → status 0(転送された)
    await fetch('/wp/admin/',  { redirect: 'manual' })  // → status 200(実体がある)

    redirect: 'manual' を指定すると、転送は「ステータス0」という特殊な状態で返ってきます。本物の200と、転送された先の200を区別できるわけです。コマンドラインの curl なら、追従オプション -L を付けないのが同じ意味になります。

    覚えておくとよい原則: 「調べるための通信」と「使うための通信」では、適切な設定が違います。使うときは自動で追ってくれたほうが楽ですが、調べるときは加工されていない生の応答が必要です。

    2. WordPressには基準となるURLが2つある

    これはWordPressを使う人だけの話ですが、はまると長引くので書いておきます。

    WordPressの「設定 → 一般」には、よく似た2つの項目があります。

    WordPress アドレス (siteurl) … WordPress本体のファイルが置いてある場所
    サイトアドレス     (home)    … 訪問者がアクセスするURL

    普通のインストールでは両方が同じ値になるので、違いを意識することはありません。ところが「WordPressを専用フォルダに入れる」構成にすると、この2つが分かれます。

    siteurl = https://cms.example.com/wp    ← 本体は /wp/ の中
    home    = https://cms.example.com       ← 見せるURLはすっきり

    この構成では、トップに置いた小さな中継ファイルが /wp/ の中身を呼び出します。訪問者に見えるURLはきれいなまま、本体のファイル群はフォルダにまとめられる、という利点があります。

    ここからが重要です。 WordPressのプラグインやテーマは、URLを組み立てるときに2つの関数を使い分けます。

    home_url()  → home    を基準にする
    site_url()  → siteurl を基準にする

    どちらを使うかは機能ごとの実装しだいです。実際、2つのAPIで判断が分かれていました。

    REST API  … home_url() 基準 → https://cms.example.com/wp-json/
    GraphQL   … site_url() 基準 → https://cms.example.com/wp/graphql

    私は「REST APIがルートに出ているのだから、GraphQLもルートだろう」と考えました。同じサイトの、同じようなAPIなのだから揃っているはずだ、と。揃っていませんでした。

    この構成を使うときは、「このURLは home と siteurl のどちらから作られるのか」を機能ごとに確認するのが正しい態度です。アップロード画像のURLも同じ理屈で影響を受けるので、画像が表示されない不具合にもつながります。

    3. エラーは「包まれている」ことがある

    これはWeb開発全般で役立つ話です。

    サーバー側のJavaScript(Node.js)で通信に失敗すると、こういうエラーが出ます。

    TypeError: fetch failed

    これだけです。 情報がほぼありません。しかも、原因が何であってもこの同じメッセージになります。

    名前解決に失敗した          → fetch failed
    接続を拒否された            → fetch failed
    証明書が一致しなかった      → fetch failed
    時間内に応答がなかった      → fetch failed

    本当の原因は cause というプロパティの中に入っています。

    try {
      await fetch(url);
    } catch (e) {
      console.error(e.message);   // "fetch failed" ← 情報ゼロ
      console.error(e.cause);     // ← ここに本体がある
    }

    実際に開けてみたら、こう書かれていました。

    Error [ERR_TLS_CERT_ALTNAME_INVALID]:
      Hostname/IP does not match certificate's altnames:
      Host: cms.example.com is not in the cert's altnames:
      DNS:*.gmoserver.jp

    一目で原因が分かります。証明書に書かれた名前が違う、と。

    これはエラーのラッピング(包装)と呼ばれる設計です。低レベルの細かいエラーを、上位の統一されたエラーで包む。使う側が実装の違いを気にしなくて済む利点がありますが、原因を調べるときは包みを開ける必要があります。

    cause はJavaScriptの標準仕様に入っている機能です。名前は環境によって違いますが(innerException、__cause__、Unwrap() など)、包む設計はどの言語にもあります。

    覚えておくとよい原則: エラーメッセージが妙に短くて抽象的なときは、その下にもう一段あります。

    4. HTTPSは「暗号化」の前に「本人確認」をしている

    HTTPSの「S」はSecure(安全)で、通信を暗号化します。ただし、暗号化の前に相手が本物かを確認する手続きがあります。

    これをTLSハンドシェイクといいます。TLSは暗号化の規格名、ハンドシェイクは握手のことです。

    1. こちらが「example.com と話したい」と伝える
    2. サーバーが、その名前に対応する証明書を返す
    3. こちらが「証明書の名前」と「アクセス先の名前」が一致するか確認する
    4. 一致すれば暗号化通信を開始、しなければ接続を中断

    証明書は身分証明書のようなものです。「このサーバーは確かに example.com です」と第三者機関が保証したデータで、そこには対象のホスト名が書かれています。

    ここで押さえておきたいのは、この確認はデータを送る前に行われるという点です。前回の失敗では、サーバーのログに「外部への通信が1本もない」と出ていました。リクエストを送って失敗したのではなく、送る前の握手で決裂していたのです。

    証明書に書かれる名前のルール

    証明書には複数の名前を書けます。*.example.com のようにワイルドカード(なんでも当てはまる記号)を使うこともできますが、ワイルドカードは1階層ぶんしかカバーしません。

    *.example.com は…
      shop.example.com     → カバーする
      a.b.example.com      → カバーしない(階層が1つ多い)
      example.com          → カバーしない(サブドメイン部分が無い)

    前回のケースでは、共用サーバーの既定の証明書 *.gmoserver.jp が返ってきていました。当然 cms.kisaku.site は含まれません。

    5. 「自分の環境から動く」は「どこからでも動く」ではない

    前回いちばん学びが大きかったのが、この点です。

    証明書の問題が見つけにくかったのは、ブラウザからは正常にアクセスできていたからでした。鍵マークも付き、データも返ってくる。それでもサーバーからは失敗する。

    なぜ結果が違うのか。通信する経路が違うからです。

    従来のサイト: ブラウザ ──────────────→ サーバー
    今回の構成  : ブラウザ → Next.js(Vercel) → WordPress
                                ↑
                    ここの通信は、ブラウザからは見えない

    従来のWordPressサイトなら、ブラウザがWordPressに直接アクセスするので、ブラウザで確認すれば十分でした。しかしヘッドレス構成ではサーバーがサーバーを呼ぶ経路が主役になります。

    この経路は、ブラウザとは別のソフトが、別の場所から、別の設定で通信しています。証明書の検証も、ブラウザとNode.jsでは厳密さが違うことがあります。

    覚えておくとよい原則: 検証は、実際に通信する経路で行わないと意味がありません。手元で動くことは、他の場所から動くことを保証しません。

    6. エラーを握りつぶす設計の功罪

    前回、データが取れていないのにビルドが「成功」し、画面も表示されてしまいました。原因はコードの書き方です。

    const results = await Promise.allSettled([
      getProjects(), getSkills(), getPosts(),
    ]);
    
    const projects = results[0].status === "fulfilled" ? results[0].value : [];

    複数の非同期処理をまとめる方法は主に2つあります。

    Promise.all        … 1つでも失敗したら、その時点で全体が失敗になる
    Promise.allSettled … 全部の結果を待って、成功・失敗を個別に返す(例外を投げない)

    allSettled を選んだ理由は「プロフィールページをまだ作っていない」といった部分的な欠損でページ全体が真っ白になるのを防ぐためでした。妥当な判断です。

    ところが今回は4つ全部が失敗しました。それでも設計どおり空の配列に置き換えられ、「まだ登録されていません」という平和な画面が出ます。

    想定していた「一部が欠ける」ではなく「全部が落ちる」が起きたとき、この防御は問題を隠す方向に働きました。

    ただし、これは allSettled が悪いという話ではありません。次の2行があれば済んでいました。

    if (results[0].status === "rejected") {
      console.error("[getProjects] failed:", results[0].reason);
    }

    覚えておくとよい原則: 「壊さない」と「気付ける」は別の要求で、両立できます。エラーを飲み込むなら、飲み込んだ記録は残す。

    7. 環境変数は「いつ」読まれるのか

    環境変数は、コードの外側から値を渡す仕組みです。「開発中はローカル、本番は本番」のように環境ごとに変わる値を扱うのに使います。

    Next.jsでは、変数名の頭に NEXT_PUBLIC_ を付けるかどうかで挙動が変わります。付けた場合、その値はビルド時にコードへ直接埋め込まれます。

    【ビルド前】process.env.NEXT_PUBLIC_API_URL
    【ビルド後】"https://cms.example.com/wp/graphql"   ← 値そのものに置き換わる

    埋め込まれたコードはブラウザに配信されるので、この値は原理的に秘密にできません。「公開してよい値にだけ付ける」というルールがあり、パスワードやAPIキーに付けてはいけないのもこのためです。

    実務上の帰結が2つあります。

    ひとつは、変更したらビルドし直さないと反映されないこと。管理画面で値を書き換えても、既存のデプロイには影響しません。

    もうひとつは、フォールバックの書き方に注意が要ることです。

    const endpoint = process.env.NEXT_PUBLIC_API_URL ?? "http://localhost:8080/graphql";

    ?? は「左が空なら右を使う」という意味です。便利ですが、本番で設定漏れがあってもエラーにならず、黙ってローカル用のURLで動き続けます。前回まさにこれで、原因の特定が遅れました。

    本番では明示的に落とす、という書き方も選択肢です。

    const endpoint = process.env.NEXT_PUBLIC_API_URL;
    if (!endpoint) throw new Error("NEXT_PUBLIC_API_URL is not set");

    覚えておくとよい原則: 親切なフォールバックは、設定ミスを見えなくします。6節と同じ構図です。

    8. DNSは2階層でできている

    DNSは、example.com のような名前と 216.198.79.1 のような数字(IPアドレス)を対応づける仕組みです。インターネットの電話帳のようなものだと考えてください。

    重要なのは、DNSが2つの階層でできていることです。

    【上位】ネームサーバー … 「このドメインの答えは、どのサーバーが持っているか」
    【下位】レコード       … 「そのサーバーが持っている、実際の答え」

    ドメインを買った会社の管理画面で「DNS設定」を開いても、そこが実際に使われているゾーンとは限りません。ネームサーバーが別の会社を向いていれば、答えを持っているのはそちらです。

    前回、まさにこれで事故を起こしかけました。開いた画面のレコード一覧が空だったので、そこに新しく設定して「ネームサーバーも変更する」にチェックを入れていたら——

    変更前: example.com → A社のDNS(3件のレコードが登録済み)
    変更後: example.com → B社のDNS(レコードは空)

    ぶら下がるすべての名前が一斉に消えます。 「このレコードには触らない」と決めていたサブドメインも、1行も触らないまま巻き添えになります。

    覚えておくとよい原則: 「レコードを触らなければ安全」は成り立ちません。上位を切り替えれば下位は丸ごと入れ替わります。そして「あるはずのものが無い」は、たいてい自分が別の場所を見ている合図です。

    9. ルートドメインにCNAMEが置けない理由

    DNSのレコードには種類があります。よく使うのは次の2つです。

    Aレコード    … この名前は、このIPアドレスです
    CNAMEレコード … この名前は、別の名前の別名です

    Vercelのようなサービスは、たいていCNAMEを推奨します。接続先のIPが変わっても自動で追従できるからです。Aレコードで直接IPを書くと、相手のインフラ変更のたびに手で直す必要が出ます。

    ところがルートドメイン(www などが付かない、ドメインそのもの)にはCNAMEを置けません。理由はこうです。

    CNAMEは「この名前は別名です」という宣言なので、そのホスト名に他のレコードを共存させられません。「別名だ」と言っているのに他の情報も持っていたら矛盾するからです。

    ところがルートドメインには、DNSの仕組み上どうしても必要なレコードがあります。

    NS  … このドメインを管理するネームサーバー(必須)
    SOA … ゾーンの管理情報(必須)
    MX  … メールの宛先(メールを使うなら必要)

    これらと共存できないため、置けないわけです。だからVercelはルートにはAレコード、www にはCNAMEを指定してきます。

    「ルートを www に転送して、www を本体にする」という構成がよく使われるのも、この事情と関係があります。実体を柔軟に追従できる側に置いておく、という設計です。

    10. 「反映されない」の9割はキャッシュ

    DNSを変更した直後に確認すると、まだ古い値が返ってきます。ここで「保存できていないのでは」と設定を触り直すと、事態が混乱します。

    DNSの答えにはTTL(Time To Live)という有効期限が付いています。世界中のDNSサーバーは、一度取得した答えをこの秒数のあいだ保存(キャッシュ)し、その間は問い合わせ直しません。毎回問い合わせていたら、世界中のDNSが処理しきれないからです。

    つまり変更直後に古い値が返るのは正常です。問題は「保存されていない」のか「キャッシュを見ている」のかをどう区別するかでした。

    役に立つのがTTLの残り秒数です。

    example.com  A 1.1.1.1  ttl600   ← 取得したばかりのキャッシュ
    example.com  A 1.1.1.1  ttl218   ← 382秒前に取得された答えを見ている
    example.com  A 2.2.2.2  ttl600   ← 期限切れ後に取り直した結果

    TTLはキャッシュの残り寿命なので、600から218に減っていれば「これは382秒前の答えだ」と分かります。いま見ている情報がいつ時点のものかを読み取れるわけです。

    さらに、パソコンとブラウザも独自にキャッシュを持っています。「サーバー側は切り替わっているのに自分のブラウザだけ古い」という状態はよく起こります。シークレットウィンドウで開くか、スマホの回線から見ると切り分けられます。

    11. 原因が分からないときに何をするか

    最後に、いちばん学びが大きかった進め方の話です。

    前回、原因を2回外しました。「環境変数の設定が悪いのでは」「ファイアウォールが遮断しているのでは」——どれも筋は通っていますが、確かめずに設定をいじり、結果が変わらず、当たったのか外れたのかも判然としない、という時間を重ねました。

    打開したのは、原因を推測するのをやめて、エラーを表示させるためだけのコードを書いたことでした。書くのに10分もかかっていません。そして一発で答えが出ました。

    この経験から言えることが2つあります。

    ひとつは、推測で1回試すコストと、確実に答えを得るコストは、思っているほど差がないということ。「調べるのは面倒だから、とりあえず怪しいところを直してみよう」と考えがちですが、外したときの時間と、外したかどうかすら分からない不確かさを考えると割に合いません。

    もうひとつは、観測できない対象を推測で潰しても意味がないということ。値が見えない状態のまま「値が間違っているかも」と考えても、直したかどうかを確認する手段がありません。まずやるべきは見えるようにすることでした。

    この記事で扱った話は、実は同じ構造を持っています。

    cause を開ける              … 隠れているエラーを見えるようにする
    redirect: 'manual' で調べる … 隠れている転送を見えるようにする
    TTLの残り秒数を読む         … 情報の鮮度を見えるようにする
    診断用のコードを書く        … 内部の状態を見えるようにする

    デバッグとは、推理することではなく、観測できる範囲を広げていく作業なのだと思います。 見えていないものについて考えている時間が長いと感じたら、それは考えを進めるタイミングではなく、見る手段を用意するタイミングです。

    まとめ

    次に似た場面で思い出せるよう、要点だけ並べておきます。

    URLを調べるときは転送の自動追従を切ること。WordPressには home と siteurl の2つの基準があり、機能によってどちらを使うかが違うこと。fetch failed は cause を開けること。HTTPSは暗号化の前に本人確認をしていて、その段階で切れると通信は1バイトも発生しないこと。検証は実際に通信する経路で行うこと。エラーを飲み込むなら記録を残すこと。NEXT_PUBLIC_ の値はビルド時に埋め込まれるので、変更後は再ビルドが要ること。DNSは2階層で、上位を切り替えると下位は丸ごと入れ替わること。ルートドメインにCNAMEは置けないこと。「反映されない」はたいていキャッシュで、TTLがいつ時点の情報かを教えてくれること。

    そして、原因が分からないときは推測を重ねるより、観測できる範囲を広げること。これがいちばんの学びでした。